လွယ်လွယ်ပြောရရင် overfitting ဆိုတာ AI က လေ့ကျင့်ခန်းတွေကို “ကျက်မှတ်ထား” ပြီး အသစ်နဲ့ ကြုံရင် မှားတဲ့ အခြေအနေ။ စာမေးပွဲမှာ အမှတ်ပြည့်ရပေမယ့် တကယ့်ဘဝမှာ ဘာမှ မလုပ်တတ်တဲ့ ကျောင်းသားလိုပဲ။
ကျွန်တော် ဒါကို ပထမဆုံး ကိုယ်တိုင် ခံစားမိတာ ကိုယ့် AI project မှာ။ Model ကို လေ့ကျင့်ထားတဲ့ ပုံတွေနဲ့ စမ်းတော့ အမှတ် ၉၉% ရတယ် — “အိုး တော်လိုက်တာ” လို့ ထင်နေတုန်း ပုံအသစ် နည်းနည်း ကွဲတာလေး ထည့်ပေးလိုက်တော့ ၆၀% ပဲ ရတော့တယ်။ အဲဒါ overfitting ပဲ။
အလွယ်ဆုံး ဥပမာနဲ့ ပြောရရင် စာမေးပွဲ ကျက်မှတ်တဲ့ ကျောင်းသားနဲ့ တူတယ်။ ဆရာက မေးခွန်း ၁၀ ခု ပေးထားတယ် — ကျောင်းသားက အဖြေ ၁၀ ခုလုံး အတိအကျ ကျက်ထားတယ်။ စာမေးပွဲမှာ အဲဒီမေးခွန်း ၁၀ ခုပဲ ပြန်မေးရင် အမှတ်ပြည့်ရမယ်။ ဒါပေမယ့် ဆရာက စကားလုံးလေး နည်းနည်း ပြောင်းပြီး မေးလိုက်ရင် ကျောင်းသားက ဖြေမတတ်တော့ဘူး။ သူက “နားလည်” ထားတာ မဟုတ်ဘဲ “ကျက်” ထားတာကိုး။ AI overfitting ဆိုတာလည်း အဲဒါပဲ — training data ကို ကျက်မှတ်ထားပြီး pattern အစစ်ကို မသင်ယူလိုက်တာ။
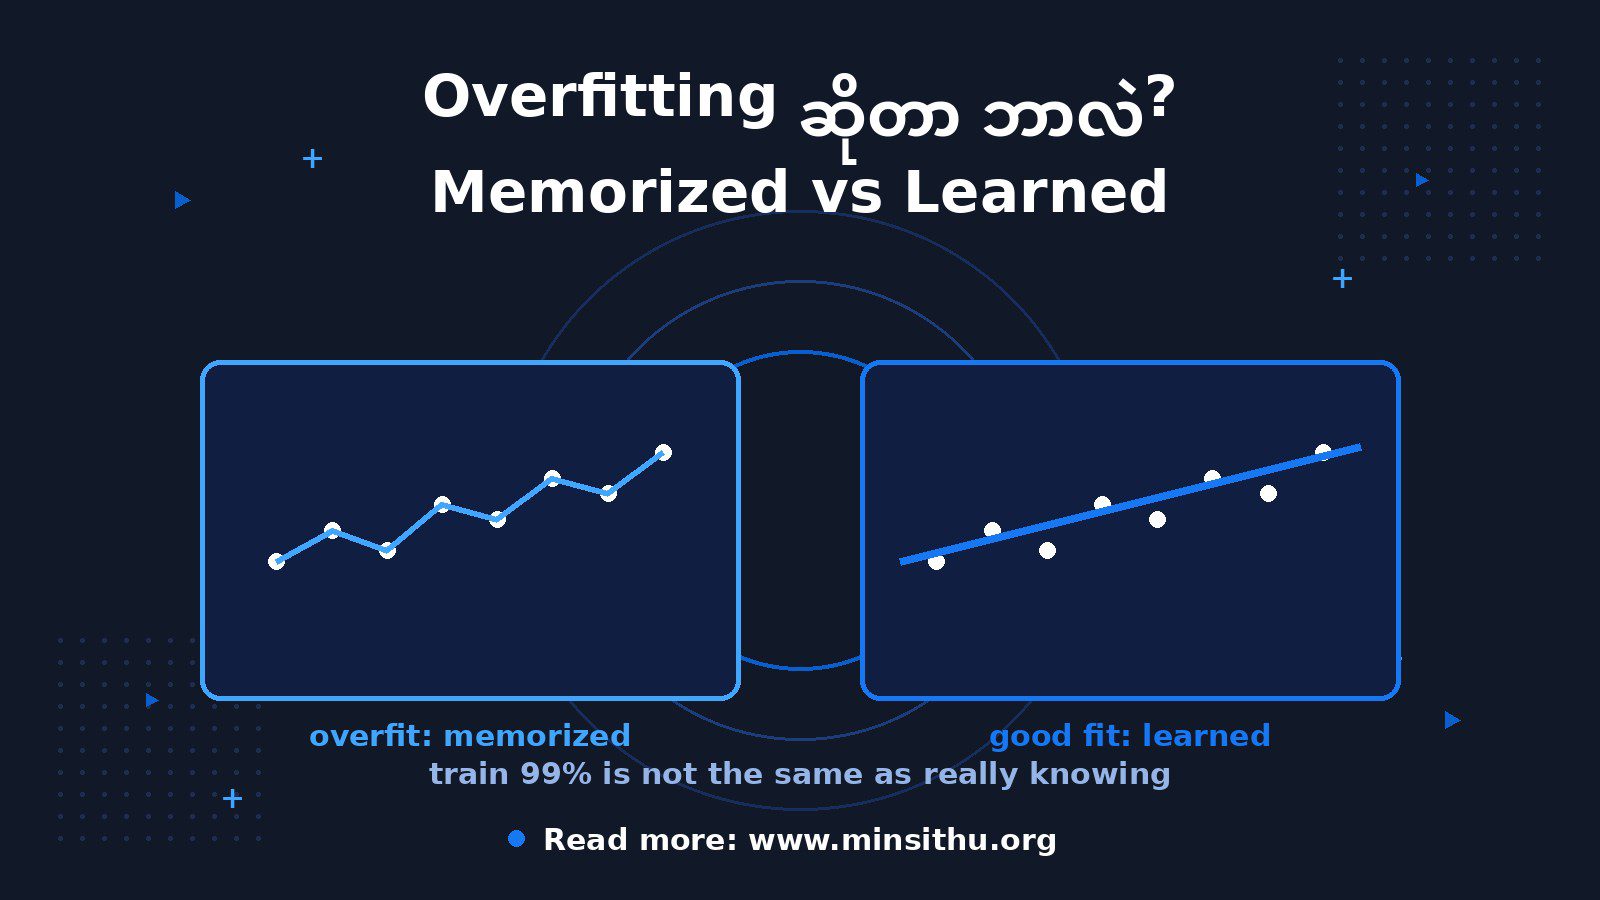
ဒါကို မျက်စိနဲ့ မြင်အောင် ပြောရရင် အမှတ် (dot) တွေ ရှိတယ် ဆိုပါစို့ — အဲဒီအမှတ်တွေကို မျဉ်းတစ်ကြောင်း ဆွဲပြီး ခန့်မှန်းရမယ်။ Overfit ဖြစ်တဲ့ model က အမှတ်တိုင်းကို ထိအောင် မျဉ်းကို ကွေးကောက် ကွေးကောက် ဆွဲတယ် — လေ့ကျင့်ခန်းမှာတော့ perfect။ ဒါပေမယ့် အမှတ်အသစ် တစ်ခုရောက်လာရင် အဲဒီကွေးကောက်မျဉ်းက လုံးဝ လွဲနေတယ်။ ကောင်းတဲ့ model ကတော့ အမှတ်တွေရဲ့ “လမ်းကြောင်း အကြမ်း” ကို ချောချောမွေ့မွေ့ ဆွဲတယ် — လေ့ကျင့်ခန်းမှာ အမှတ်နည်းနည်း လွဲပေမယ့် အသစ်နဲ့ ကြုံရင် ပိုမှန်တယ်။ ဒါကို bias-variance tradeoff လို့ ခေါ်တယ်၊ နာမည်ကြီးပေမယ့် အဓိပ္ပာယ်က ဒီလောက်ပဲ — ကျက်မှတ်လွန်းတာနဲ့ အကြမ်းဖျင်း သိတာကြား ချိန်ညှိတာ။
Overfitting ဘာလို့ ဖြစ်တာလဲ။ အကြောင်းရင်း သုံးခု အဓိက ရှိတယ်။
Model ကြီးလွန်းတာ — parameter သန်းချီရှိတဲ့ model ကို ပုံတစ်ထောင်နဲ့ လေ့ကျင့်ရင် သူက ပုံတစ်ပုံချင်းစီကို မှတ်မိဖို့ လွယ်တယ်။ ဦးနှောက်ကြီးပြီး စာနည်းနည်းပဲ ဖတ်ရတဲ့ ကျောင်းသားလိုပဲ
Data နည်းလွန်းတာ — လေ့ကျင့်ခန်း နည်းရင် model က “အထွေထွေ စည်းမျဉ်း” ထက် “ဒီဥပမာတွေ” ကို မှတ်ဖို့ ရွေးတယ်
Epoch များလွန်းတာ — data အတူတူကို အကြိမ်ရေ အများကြီး ပြန်ပြန်သင်ရင် နောက်ဆုံး ကျက်မှတ်သွားရော
ဒါကို ဘယ်လို သိမလဲ။ လက္ခဏာက ရှင်းတယ် — training accuracy တက်နေပြီး test/validation accuracy ကျသွားတာ (ဒါမှမဟုတ် ရပ်နေတာ)။ လေ့ကျင့်ခန်းမှာ ၉၉%၊ အသစ်မှာ ၇၀% ဆိုရင် သံသယ ဝင်တော့။
ဖြေရှင်းနည်းတွေလည်း ရှိတယ် —
Data များများ ထည့်ပါ — အကောင်းဆုံး ဆေး။ ဥပမာ များလေ ကျက်မှတ်လို့ မရလေ
Data augmentation — ပုံကို လှည့်၊ ဖြတ်၊ အလင်းပြောင်းပြီး “အသစ်” လို လုပ်တာ
Dropout — လေ့ကျင့်နေတုန်း neuron တချို့ကို မတော်တဆ ပိတ်ထားတာ။ ကျောင်းသားကို တစ်ခါတလေ စာအုပ် မကြည့်ဘဲ ဖြေခိုင်းသလိုပဲ — မှတ်ဉာဏ်ကို အားကိုးလို့ မရအောင် လုပ်တာ
Regularization — model ကို “ရိုးရိုးရှင်းရှင်း တွေးပါ” လို့ ဒဏ်ပေးတဲ့ နည်းလမ်း
Early stopping — validation accuracy ရပ်သွားတာနဲ့ လေ့ကျင့်တာ ရပ်ပစ်တာ
ကျွန်တော် အမှတ်ရဆုံး သင်ခန်းစာက ဒါပဲ — AI ရဲ့ အမှတ်က “လေ့ကျင့်ခန်းမှာ ဘယ်လောက်မှန်လဲ” မဟုတ်ဘူး၊ “မမြင်ဖူးတဲ့ အသစ်နဲ့ ကြုံရင် ဘယ်လောက်မှန်လဲ” ဆိုတာပဲ။ ဒါကြောင့် AI demo တွေ ကြည့်ရင် သတိထားပါ — ပြထားတဲ့ ဥပမာတွေမှာ တော်နေတာ သူ့ training data ထဲက ဖြစ်နိုင်တယ်။ ကိုယ့်အလုပ်မှာ သုံးမယ်ဆိုရင် ကိုယ့် data အသစ်နဲ့ ကိုယ်တိုင် စမ်းကြည့်မှ တကယ် သိရမယ်။
ကျက်မှတ်တတ်တာ လူရော AI ရော အတူတူပဲ — တကယ် နားလည်ဖို့က ပိုခက်တယ်။ 🙂