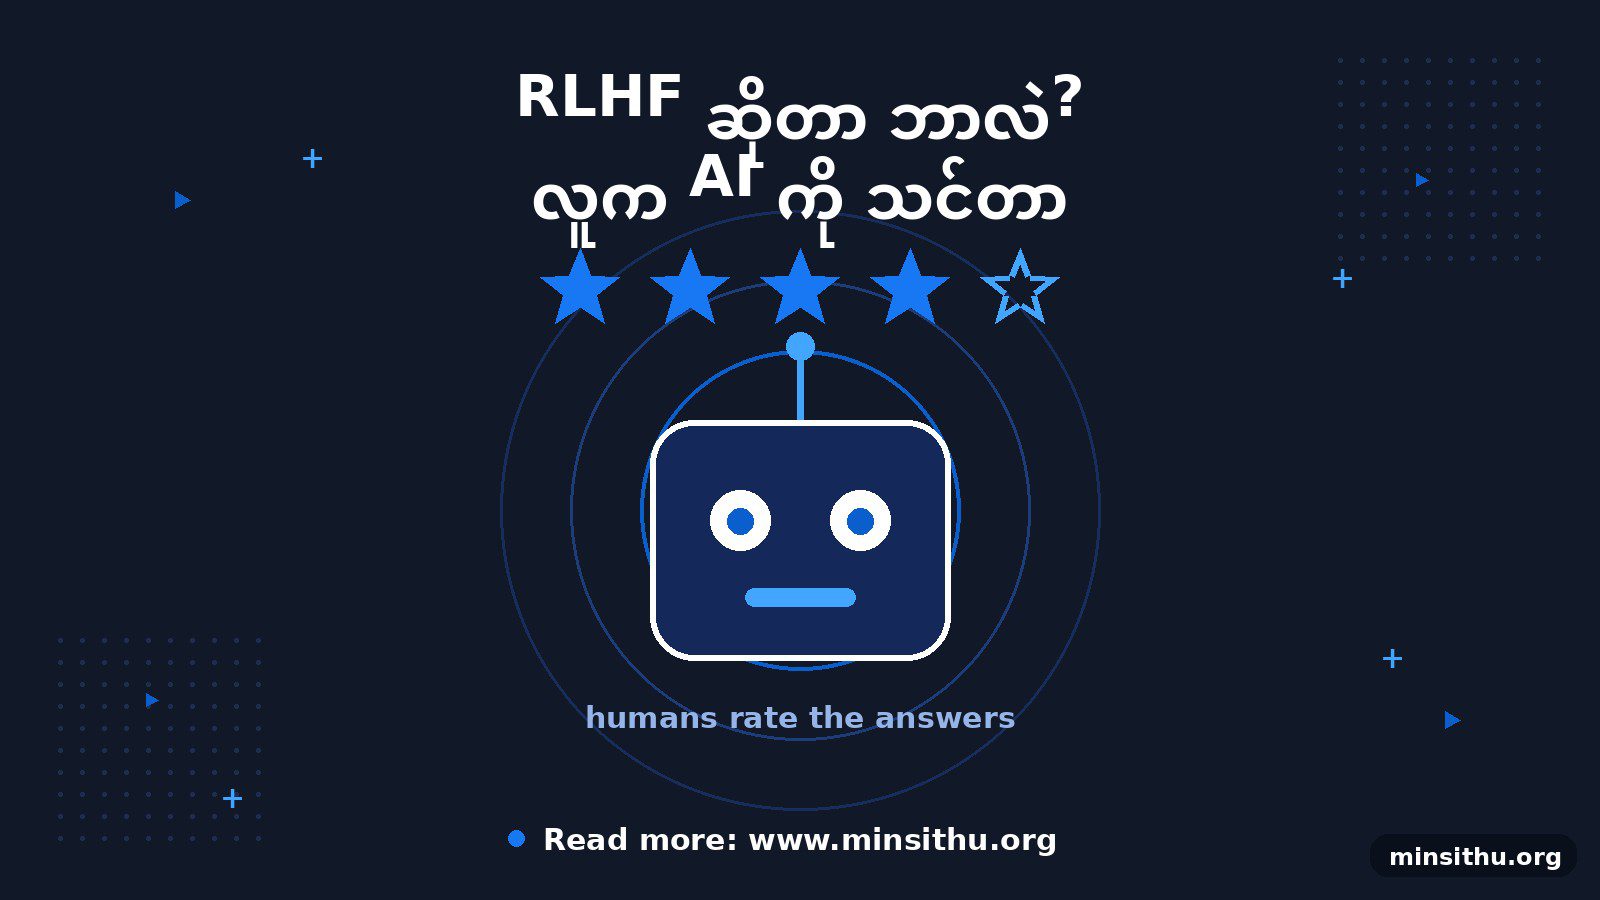
လွယ်လွယ်ပြောရရင် RLHF ဆိုတာ AI ကို စာတွေ ဖတ်ခိုင်းတာနဲ့ မပြီးဘဲ၊ လူတွေကိုယ်တိုင် “ဒီအဖြေက ကောင်းတယ်၊ ဒီအဖြေက မကောင်းဘူး” လို့ အမှတ်ပေးပြီး သင်တဲ့ နည်းပါ။ RLHF = Reinforcement Learning from Human Feedback — လူရဲ့ feedback ကနေ သင်ယူတဲ့ နည်းပေါ့။ နာမည်က ကြောက်စရာကောင်းပေမယ့် အဓိပ္ပာယ်က ရိုးရိုးလေးပါ။
စားဖိုမှူး လက်သစ်တစ်ယောက်ကို စဉ်းစားကြည့်ပါ။
ဆရာစားဖိုမှူးက လက်သစ်ကို ဟင်းတစ်ခွက် ချက်ခိုင်းတယ်။ လက်သစ်က တစ်ခါတည်း အကောင်းဆုံး ချက်တတ်မှာ မဟုတ်ဘူး — သုံးမျိုးလောက် စမ်းချက်ကြည့်တယ်။ ဆရာက တစ်ခွက်ချင်း မြည်းစမ်းပြီး အမှတ်ပေးတယ် — “ဒါက နည်းနည်း ငန်တယ်၊ ၆ မှတ်။ ဒါက အရသာကောင်းတယ်၊ ၉ မှတ်။ ဒါကတော့ စားမရဘူး၊ ၂ မှတ်။”
လက်သစ်က အမှတ်တွေ ကြည့်ပြီး နားလည်သွားတယ် — “ဪ၊ ဆရာကြိုက်တဲ့ အရသာက ဒီလိုမျိုး” ဆိုတာ။ နောက်တစ်ခါ ချက်တော့ ၉ မှတ်ရတဲ့ ပုံစံဘက် ပိုနီးအောင် ချက်တယ်။ အမှတ်ပေးခံရတာ များလေ၊ ဆရာ့အကြိုက် မှန်လေပဲ။
RLHF လည်း ဒီအတိုင်းပဲ။ AI က မေးခွန်းတစ်ခုကို အဖြေ သုံးလေးမျိုး ထုတ်ပေးတယ်။ လူတွေက “ဒီအဖြေက အကောင်းဆုံး၊ ဒါက ဒုတိယ၊ ဒါက အဆိုးဆုံး” လို့ စီပေးတယ်။ AI က အဲဒီအစီအစဉ်ကို ကြည့်ပြီး “လူကြိုက်တဲ့ အဖြေပုံစံက ဒါပဲ” ဆိုတာ သင်ယူသွားတယ်။
သုံးဆင့် ရှိတယ်
အရင် စာသင်ပေး — AI ကို စာတွေ အများကြီး ဖတ်ခိုင်းပြီး အခြေခံ တတ်အောင် လုပ်တယ် (ဒါက သာမန် training)
လူက အမှတ်ပေး — AI ထုတ်တဲ့ အဖြေတွေကို လူတွေ အစဉ်လိုက် စီပေးတယ်။ “ဒီအဖြေက ယဉ်ကျေးတယ်၊ ဒါက ရိုင်းတယ်” တို့လို
အမှတ်များအောင် ပြန်သင် — AI ကို အမှတ်များတဲ့ အဖြေမျိုး ထုတ်တတ်အောင် ထပ်သင်တယ် (ဒါက reinforcement learning အပိုင်း)
ဥပမာ ကိုယ်က “စိတ်ညစ်နေတယ်၊ ဘာလုပ်ရမလဲ?” လို့ မေးရင် AI က “စိတ်ညစ်တာက မင်းအပြစ်ပဲ” လို့ ဖြေတာနဲ့ “စိတ်ညစ်တာ လူတိုင်းဖြစ်တတ်ပါတယ်၊ ဒီလိုလေးတွေ စမ်းကြည့်ပါ” လို့ ဖြေတာ — လူက ဒုတိယအဖြေကို အမှတ်ပိုပေးတယ်။ အဲဒီလို အမှတ်ပေးခံရတာ သန်းနဲ့ချီများလာတော့ AI က “လူကို ဖေးမတဲ့ပုံစံနဲ့ ဖြေရမယ်” ဆိုတာ စွဲသွားတယ်။
ChatGPT, Claude တို့ရဲ့ ယဉ်ကျေးပြီး အကူအညီဖြစ်တဲ့ လေသံက ဒီနည်းကနေ လာတာပါ။ မွေးရာပါ စိတ်ကောင်းရှိလို့ မဟုတ်ဘူး — လူတွေ အမှတ်ပေးသင်ထားလို့ပါ။
ကိုယ်တို့ like/dislike ခလုတ် နှိပ်တဲ့ feedback တွေလည်း ဒီထဲ ပါဝင်တယ်။ ကိုယ် အမှတ်ပေးလိုက်တဲ့ အဖြေတိုင်းက နောက် AI ပိုကောင်းလာဖို့ သင်ခန်းစာတစ်ခု ဖြစ်နေတာပါ။
ဒါပေမယ့် သတိထားစရာလည်း ရှိတယ် — လူပေးတဲ့ အမှတ်က တစ်ခါတလေ ဘက်လိုက်တတ်တယ်။ အမှတ်ပေးတဲ့သူ အကြိုက်လိုက်ပြီး AI က “လူကြိုက်အောင် ချိုချိုသာသာ လိမ်ပြော” တတ်တာမျိုး ဖြစ်နိုင်တယ် (ဒါကို sycophancy လို့ ခေါ်တယ်)။ ဒါကြောင့် အမှတ်ပေးတဲ့သူ ရွေးတာ၊ စည်းမျဉ်းချတာတွေက RLHF ရဲ့ အရေးကြီးဆုံး အလုပ်ပဲ။
လူက AI ကို သင်ပေးနေတာ — ဒါပေမယ့် လူရဲ့ အကြိုက်ကိုယ်တိုင်က မှန်ကန်ဖို့ လိုတယ်။ ဆရာကောင်းမှ တပည့်ကောင်းမယ် ဆိုသလိုပေါ့။ 🙂