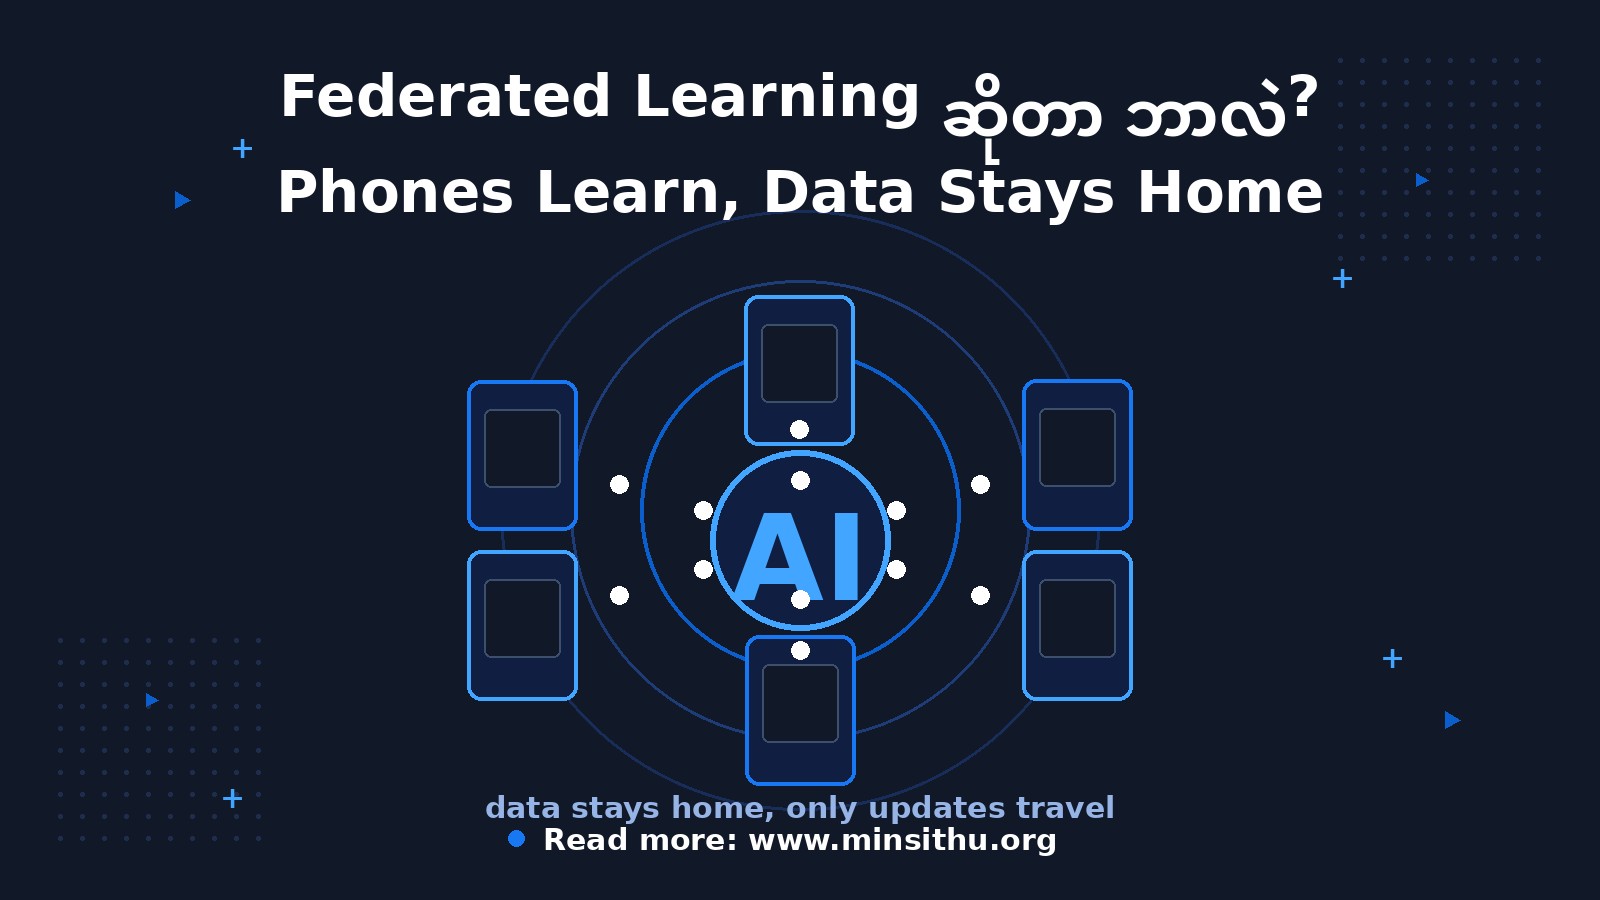
လွယ်လွယ်ပြောရရင် Federated Learning ဆိုတာ AI ကို သင်ပေးဖို့ ကိုယ့်ရဲ့ data တွေကို server ဆီ ပို့စရာမလိုဘဲ၊ model ကိုပဲ ကိုယ့်ဖုန်းဆီ ပို့ပြီး ဖုန်းပေါ်မှာတင် သင်ပေးတဲ့ နည်းလမ်းပါ။
ကျွန်တော် ဒါကို ပထမဆုံး ကြားတုန်းက “ဟာ၊ ဒါဆို AI က ငါ့ဖုန်းထဲက စာတွေကို ခိုးဖတ်စရာ မလိုတော့ဘူးပေါ့” လို့ တွေးမိတယ်။ အရင်က AI ကို သင်ပေးချင်ရင် data အကုန်လုံးကို server ပေါ် စုရတယ်။ ဥပမာ keyboard app က နောက်စကားလုံး ခန့်မှန်းတတ်အောင် သင်ပေးချင်ရင် လူတိုင်းရဲ့ ရိုက်ထားတဲ့ စာတွေကို server ဆီ ပို့ရမယ် — အဲဒါက တော်တော် လန့်စရာကောင်းတယ် မဟုတ်လား?
ကျောင်းသားတွေ အိမ်စာကို အိမ်မှာပဲ လုပ်သလိုပဲ
Federated Learning ရဲ့ စိတ်ကူးကို ဒီလိုနဲ့ ရှင်းပြမယ်။
ဆရာတစ်ယောက်က ကျောင်းသား ၁၀၀၀ ကို စာသင်ချင်တယ်။ အရင်နည်းက ကျောင်းသားတွေရဲ့ အိမ်စာစာအုပ်အကုန်လုံးကို ဆရာဆီ အပ်ခိုင်းပြီး ဆရာက တစ်အုပ်ချင်း ဖတ်တာ။ Federated Learning နည်းကတော့ ဆရာက “သင်ခန်းစာ” ကိုပဲ ကျောင်းသားတွေဆီ ပို့တယ်။ ကျောင်းသားက အိမ်မှာ ကိုယ့်ဘာသာ လေ့ကျင့်တယ်။ ပြီးတော့ စာအုပ်ကို ပြန်မပို့ဘဲ “ဒီအပိုင်းကို နားလည်သွားပြီ၊ ဒီအပိုင်းတော့ နည်းနည်း ခက်တယ်” ဆိုတဲ့ အကျဉ်းချုပ်လေးပဲ ဆရာဆီ ပြန်ပို့တယ်။ ဆရာက အကျဉ်းချုပ် ၁၀၀၀ ကို စုပြီး သင်ခန်းစာကို ပိုကောင်းအောင် ပြင်တယ်။
ဒီလိုပဲ AI model ကို သင့်ဖုန်းဆီ ပို့တယ်။ သင့်ဖုန်းက သင့်ရဲ့ data (ဥပမာ သင် ရိုက်နေကျ စကားလုံးတွေ) နဲ့ model ကို နည်းနည်း လေ့ကျင့်ပေးတယ်။ ပြီးတော့ data ကို မပို့ဘဲ “model ဘယ်လို ပြောင်းလဲသွားလဲ” ဆိုတဲ့ အပြောင်းအလဲလေးပဲ server ဆီ ပြန်ပို့တယ်။ Server က ဖုန်းထောင်ပေါင်းများစွာဆီက အပြောင်းအလဲတွေကို ပျမ်းမျှယူပြီး model အသစ်ကို ထုတ်တယ်။ ဒါကို သုတေသီတွေက FedAvg လို့ ခေါ်တယ်။
တကယ့် ဥပမာ ၃ ခု
၁။ Gboard ရဲ့ နောက်စကားလုံး ခန့်မှန်းတာ
Google ရဲ့ Gboard က သင် ရိုက်နေကျ စကားလုံးတွေကို သင့်ဖုန်းပေါ်မှာတင် လေ့လာတယ်။ သင်ရိုက်တဲ့ စာအပြည့်အစုံကို Google server ဆီ မပို့ဘူး။ Model update လေးပဲ ပို့တယ်။ ဒါကြောင့် “မင်္ဂလာပါ” လို့ ရိုက်ပြီးရင် “ခင်ဗျား” လို့ အလိုလို ပေါ်လာတာမျိုး ပိုတိကျလာတယ်။
၂။ ဆေးရုံတွေ ပူးပေါင်းပြီး AI သင်တာ
ဆေးရုံ ၅ ရုံက ကင်ဆာ ဓာတ်မှန်ပုံတွေနဲ့ AI သင်ချင်တယ်ဆိုပါစို့။ လူနာရဲ့ ဓာတ်မှန်ပုံကို တခြားဆေးရုံကို ပို့လို့ မရဘူး — ကိုယ်ရေးကိုယ်တာ ဥပဒေနဲ့ ငြိတယ်။ Federated Learning နဲ့ဆို ဆေးရုံတိုင်းက ကိုယ့်ဓာတ်မှန်ပုံတွေနဲ့ ကိုယ့်ဘာသာ သင်ပြီး model update လေးပဲ ဖလှယ်တယ်။ လူနာရဲ့ ပုံအစစ်က ဆေးရုံထဲကကို မထွက်ဘူး။
၃။ Voice Assistant ကို ပိုကောင်းအောင် လုပ်တာ
Siri, Google Assistant တို့လို voice assistant တွေက သင့်အသံကို ပိုနားလည်လာအောင် သင့်ဖုန်းပေါ်မှာတင် နည်းနည်း လေ့ကျင့်ပေးတယ်။ သင့်ရဲ့ အသံဖိုင်အစစ်ကို server ဆီ မပို့ဘဲ လေ့လာနိုင်တယ်။
ဒါဆို လုံးဝ လုံခြုံပြီလား?
ဝမ်းနည်းစရာ အဖြေက — မလုံခြုံသေးဘူး၊ ဒါပေမယ့် အရင်ကထက် အများကြီး ပိုကောင်းလာတယ်။
သတိထားရမယ့် အချက်တွေ ရှိတယ်—
model update လေးထဲကနေတောင် တခါတလေ မူလ data ရဲ့ အရိပ်အယောင် ပြန်ဖော်လို့ ရနိုင်တယ်။ ဒါကြောင့် Secure Aggregation လို့ခေါ်တဲ့ “update တွေကို ရောနှောပြီးမှ ပို့တာ” နဲ့ Differential Privacy လို့ခေါ်တဲ့ “ဆူညံသံလေး ထည့်တာ” တွေကို တွဲသုံးကြတယ်။
ဖုန်းတိုင်းရဲ့ data က မတူဘူး။ တစ်ယောက်က မြန်မာစာ ရိုက်တယ်၊ တစ်ယောက်က အင်္ဂလိပ်စာ ရိုက်တယ်။ ဒီလို မညီမျှတဲ့ data တွေနဲ့ သင်ရင် model က တစ်ဖက်ကို ယိမ်းသွားနိုင်တယ်။
ဖုန်းတစ်လုံးက ရည်ရွယ်ချက်ရှိရှိ model ကို ဖျက်ဆီးတဲ့ update ပို့ရင် တစ်ဖွဲ့လုံးရဲ့ model ပျက်သွားနိုင်တယ်။ ဒါကို Poisoning Attack လို့ ခေါ်တယ်။
ကိုယ့်အတွက် ဘာအရေးကြီးလဲ?
သင် ဖုန်းတစ်လုံး သုံးနေသရွေ့ သင့်ရဲ့ data က သင့်ဖုန်းထဲမှာတင် အလုပ်လုပ်နေတဲ့ ခေတ်ကို ရောက်နေပြီ။ “AI ကို ပိုကောင်းအောင် လုပ်ပေးပါ” လို့ app တစ်ခု တောင်းလာရင်၊ အဲဒီ app က federated learning သုံးသလား၊ data အကုန်လုံးကို server ဆီ ပို့သလား ဆိုတာကို စစ်ကြည့်ပါ။
အနာဂတ်မှာ AI က ပိုထက်မြက်လာမယ်၊ ဒါပေမယ့် ကိုယ့် data က ကိုယ့်အိမ်ထဲမှာပဲ နေမယ့် ခေတ်လည်း ဖြစ်လာမယ်။ အဲဒီခေတ်ရဲ့ အစပဲ Federated Learning က။ 🙂