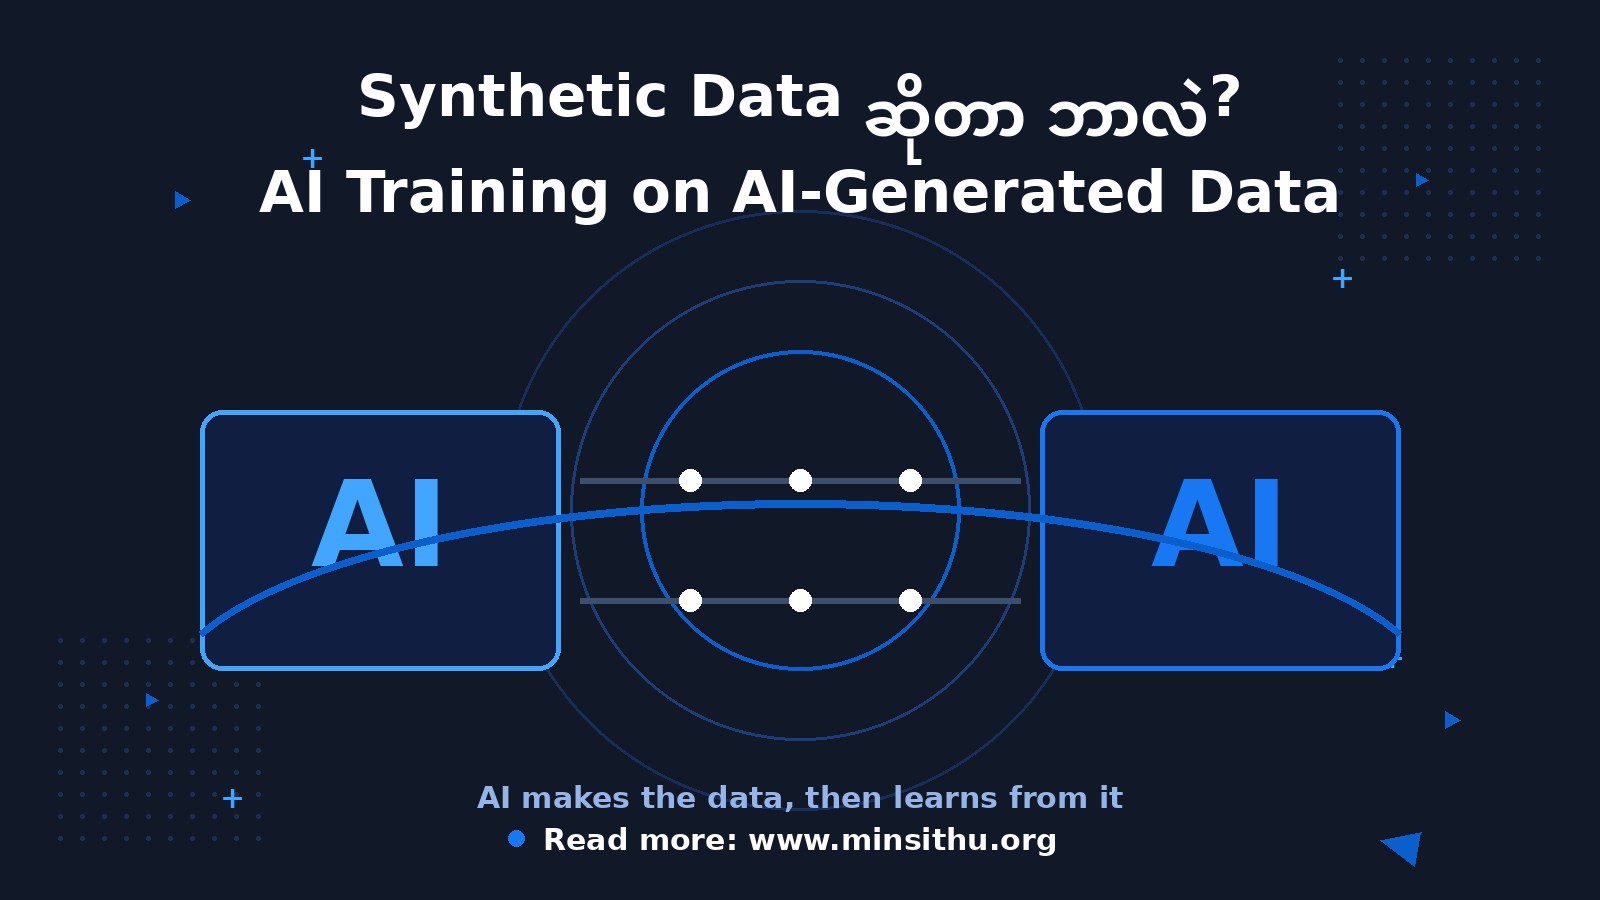
လွယ်လွယ်ပြောရရင် Synthetic Data ဆိုတာ AI ကို သင်ပေးဖို့ လိုအပ်တဲ့ data အစစ်အမှန် မရှိတဲ့အခါ AI ကိုယ်တိုင် (ဒါမှမဟုတ် simulation တစ်ခုခု) ကနေ ထုတ်ယူထားတဲ့ “data အတု” ကို သုံးပြီး သင်ပေးတဲ့ နည်းလမ်းပါ။
ကျွန်တော် ဒီအကြောင်းကို ပထမဆုံး ကြားတုန်းက နည်းနည်း ရယ်မိတယ် — AI ကို သင်ပေးဖို့ AI ပဲ data ထုတ်ခိုင်းတာ၊ ဆရာက ကျောင်းသားကို သင်ဖို့ ကျောင်းသားကိုယ်တိုင်ပဲ စာမေးပွဲ မေးခွန်းထုတ်ခိုင်းသလိုပဲ မဟုတ်လား? ဒါပေမယ့် တကယ်တမ်း စဉ်းစားကြည့်တော့ ဒါက တော်တော် လက်တွေ့ကျတဲ့ ဖြေရှင်းနည်းတစ်ခု ဖြစ်နေတယ်။
ဘာလို့ data အတု လိုလာတာလဲ?
AI ကို သင်ပေးဖို့ data အများကြီး လိုတယ် ဆိုတာ သင် သိပြီးသားပါ။ ဒါပေမယ့် data အစစ်အမှန် စုဖို့က တခါတလေ—
ဈေးကြီးလွန်းတယ်။ ဥပမာ ကားမောင်းတဲ့ AI ကို သင်ဖို့ ကားအက်ဆီးဒင့်ဖြစ်တဲ့ မြင်ကွင်းပေါင်း ထောင်ချီ လိုတယ် — ဒါပေမယ့် အက်ဆီးဒင့်ကို ရည်ရွယ်ချက်ရှိရှိ ရိုက်ယူလို့ မရဘူးလေ။
Private ဖြစ်လွန်းတယ်။ ဆေးရုံက လူနာတွေရဲ့ ဓာတ်မှန်ပုံတွေကို AI သင်ဖို့ တိုက်ရိုက်သုံးလို့ မရဘူး — လူနာရဲ့ ကိုယ်ရေးအချက်အလက် ဥပဒေနဲ့ ငြိတယ်။
ရှားပါးလွန်းတယ်။ လေယာဉ်ပျက်ကျတာ တစ်နှစ်မှာ ဘယ်နှခါ ရှိလို့လဲ? ဒါပေမယ့် လေယာဉ်မောင်း AI ကို အရေးပေါ်အခြေအနေအတွက် သင်ပေးရမယ်။
ဒီလို အခြေအနေတွေမှာ “data အစစ်မရှိရင် data အတု ဖန်တီးပြီး သင်မယ်” ဆိုတဲ့ စိတ်ကူးက ပေါ်လာတာပါ။
ဘယ်လို ဖန်တီးကြတာလဲ? (ဥပမာ ၃ ခု)
၁။ Simulation ထဲကနေ ထုတ်တာ
Self-driving ကားကုမ္ပဏီတွေ (Tesla, Waymo) က ကားအစစ်ကို လမ်းပေါ် တကယ် မောင်းခိုင်းတာအပြင် video game လိုမျိုး virtual မြို့ထဲမှာပါ မောင်းခိုင်းတယ်။ အက်ဆီးဒင့်၊ မိုးသည်းထန်စွာရွာတာ၊ လမ်းပေါ် ခွေးပြေးထွက်လာတာ — ဒါတွေကို computer ထဲမှာ အကြိမ်ရေ သန်းချီပြီး စမ်းသပ်လို့ ရတယ်။ ရလာတဲ့ data တွေက အစစ်မဟုတ်ပေမယ့် AI သင်ဖို့ လုံလောက်တယ်။
၂။ AI ကိုယ်တိုင် ထုတ်ခိုင်းတာ
Chatbot ကို သင်ဖို့ လူတွေ မေးတဲ့ မေးခွန်းအစစ် သန်းချီ လိုတယ် — ဒါပေမယ့် AI ကိုယ်တိုင်က “လူ မေးနိုင်တဲ့ မေးခွန်းပုံစံ” ကို ထုတ်ပြီး အဲဒါနဲ့ ပြန် သင်တယ်။ Diffusion model တွေလည်း ပုံအတု သန်းချီထုတ်ပြီး တခြား model တွေကို သင်ပေးဖို့ သုံးကြတယ်။
၃။ Rule နဲ့ တွက်ထုတ်တာ
ဘဏ်က လိမ်လည်မှု (fraud) ထောက်လှမ်းတဲ့ AI ကို သင်ဖို့ တကယ့် fraud transaction တွေ ရှားတယ်။ ဒါကြောင့် “ဒီလို ပုံစံမျိုးက fraud ဖြစ်နိုင်တယ်” ဆိုတဲ့ rule တွေနဲ့ transaction အတုတွေ ထုတ်ပြီး သင်တယ်။
သတိထားရမယ့် အန္တရာယ် — “မိတ္တူကူးထားတာကို ထပ်ကူးသလို”
ကျွန်တော် အကြိုက်ဆုံး ဥပမာနဲ့ ရှင်းပြမယ်။ စာရွက်တစ်ရွက်ကို မိတ္တူကူးတယ် — ပထမအကြိမ်က ကြည်တယ်။ အဲဒီ မိတ္တူကိုပဲ ထပ်ကူးတယ် — နည်းနည်း မှုန်လာတယ်။ အဲဒါကိုပဲ ထပ်ထပ်ကူးသွားရင် နောက်ဆုံးမှာ ဘာရေးထားမှန်း မသိတော့ဘူး။
Synthetic data လည်း အတူတူပဲ။ AI ထုတ်ထားတဲ့ data နဲ့ AI အသစ်ကို သင်တယ်၊ အဲဒီ AI အသစ်ထုတ်တဲ့ data နဲ့ နောက်တစ်လုံးကို ထပ်သင်တယ် — ဒီလို အကြိမ်ကြိမ် လုပ်သွားရင် model က တဖြည်းဖြည်း “ပျက်စီး” သွားတယ်။ သုတေသီတွေက ဒါကို Model Collapse လို့ ခေါ်တယ်။
ဒါကြောင့် synthetic data သုံးတဲ့အခါ—
data အစစ်နဲ့ ရောသုံးရတယ် (အတုချည်း မဟုတ်ဘူး)
အတုဖြစ်ကြောင်း မှတ်သားထားရယ် (watermark လိုမျိုး)
Quality ကို လူက စစ်ဆေးပေးရတယ်
ကိုယ့်အတွက် ဘာအရေးကြီးလဲ?
သင် AI tool တစ်ခု သုံးနေရင်၊ အဲဒီ tool ရဲ့ အဖြေတွေထဲမှာ “အတုနံ့” နည်းနည်း ရနေရင် — ဖြစ်နိုင်ခြေတစ်ခုက အဲဒီ model ကို synthetic data များများနဲ့ သင်ထားလို့ပါ။ အထူးသဖြင့် ရှားပါးတဲ့ အကြောင်းအရာ (ဥပမာ မြန်မာစာ နက်နက်နဲနဲ) မေးတဲ့အခါ သတိထားပါ။
AI ခေတ်မှာ “data” ဆိုတာ ရေနံလိုပဲ တန်ဖိုးရှိလာပြီ — အစစ်ရော အတုရော။ အတုကို ဘယ်လို သုံးရမယ် ဆိုတာသိတာက နောက်လာမယ့် နှစ်တွေမှာ တော်တော် အရေးပါလာမယ့် skill တစ်ခု ဖြစ်လာမှာပါ။ 🙂