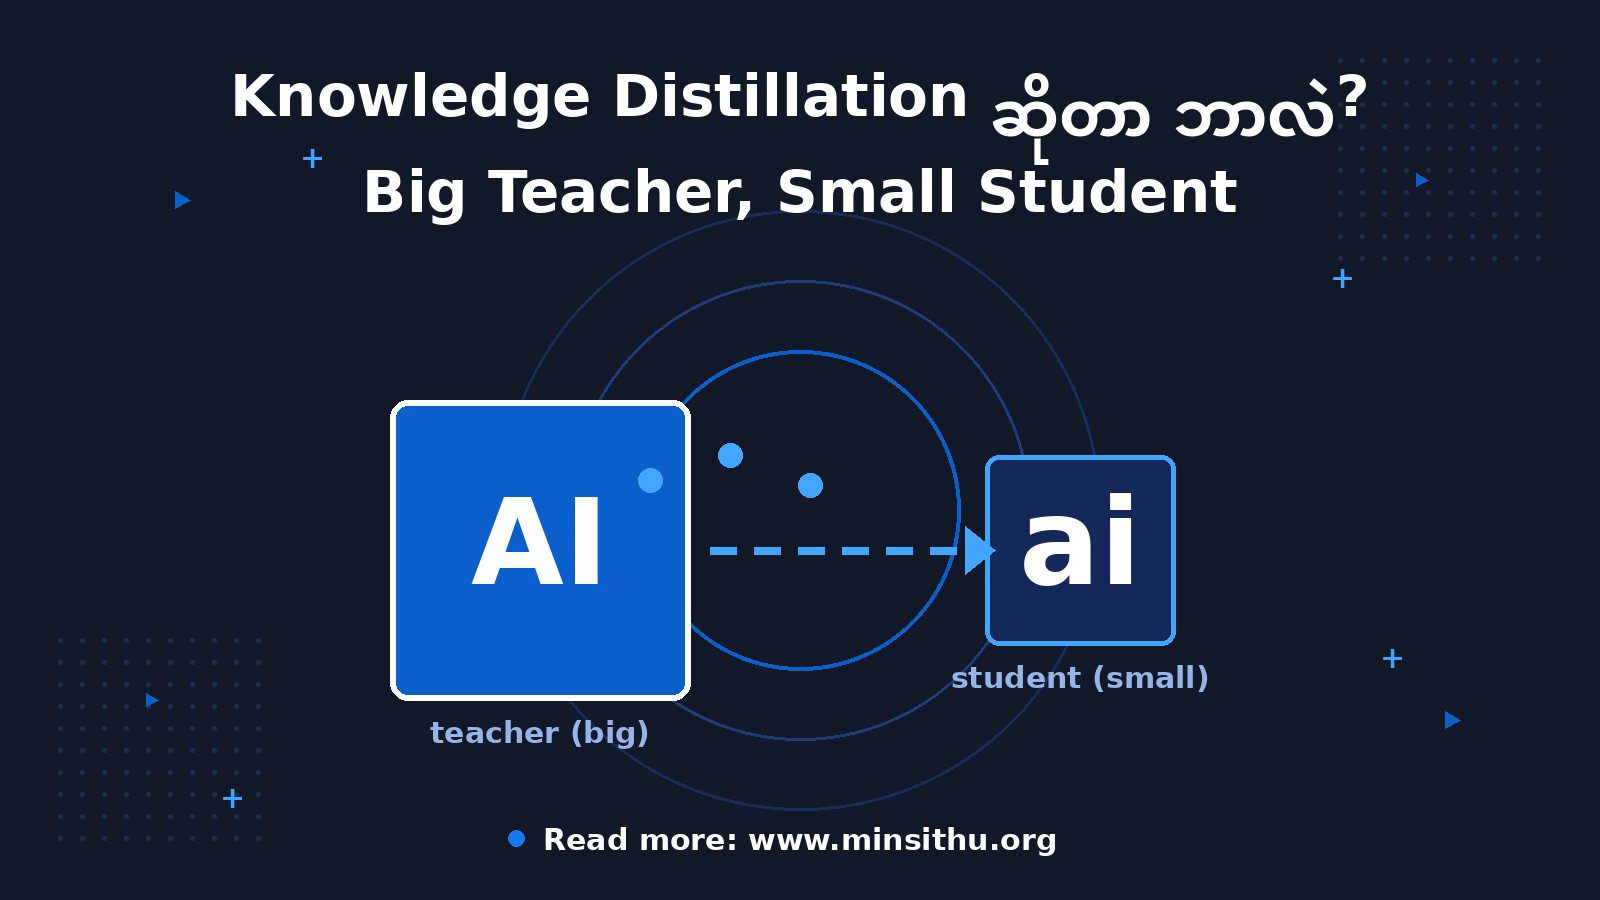
လွယ်လွယ်ပြောရင် Knowledge Distillation ဆိုတာ AI model အကြီးကြီး (teacher) က သူ့ရဲ့ အသိပညာတွေကို AI model အသေးလေး (student) ဆီ လွှဲပြောင်းပေးတဲ့ နည်းပညာပါ။ ရလဒ်က ကြီးတဲ့ model လောက် တော်တဲ့ — ဒါပေမယ့် အရွယ်အစား တော်တော် သေးတဲ့ model တစ်ခု ရလာတယ်။
ဆရာနဲ့ တပည့် ဥပမာနဲ့ ပြောရအောင်။ ဆရာကြီး တစ်ယောက်က စာအုပ်အထပ်လိုက် ဖတ်ထားတယ် — သူ့ခေါင်းထဲမှာ အသိပညာ အများကြီး ရှိတယ်။ သူက တပည့်ကို သင်ပေးတဲ့အခါ စာအုပ်အထပ်လိုက် ပြန်ဖတ်ခိုင်းတာ မဟုတ်ဘူး။ အဓိက အချက်တွေ၊ ဉာဏ်ကောင်းတဲ့ နည်းလမ်းတွေ၊ မှားတတ်တဲ့ နေရာတွေကို ပြောပြတယ်။ တပည့်က စာအုပ်အကုန် မဖတ်ရဘဲ ဆရာ့ရဲ့ “အနှစ်” ကို ရသွားတယ်။ Knowledge Distillation က ဒီလိုပါပဲ — teacher model ကြီးက သူ သင်ထားတာတွေရဲ့ အနှစ်ကို student model သေးသေးလေးဆီ ပေးလိုက်တာ။
ဘယ်လို အလုပ်လုပ်လဲ —
အရင်ဆုံး teacher model အကြီးကြီး တစ်ခု ရှိရမယ် (ဥပမာ BERT လို ကြီးတဲ့ model)
Teacher ကို ပုံမှန် data နဲ့ train တယ် — ဒါက အချိန်ကုန်၊ ငွေကုန်တဲ့ အဆင့်
ပြီးရင် student model သေးသေးလေးကို teacher ရဲ့ အဖြေတွေနဲ့ train ပြန်တယ်။ ဒီမှာ အရေးကြီးတဲ့ အချက်က teacher က “ဒါက ခွေး” လို့ ပြတ်ပြတ်သားသား ပြောတာမျိုး မဟုတ်ဘဲ “ဒါ 90% ခွေး ဖြစ်နိုင်တယ်၊ 8% ဝံပုလွေ ဖြစ်နိုင်တယ်၊ 2% မြေခွေး ဖြစ်နိုင်တယ်” ဆိုတဲ့ soft answer မျိုး ပေးတာ။ ဒီ soft answer ထဲမှာ teacher ရဲ့ “အတွေ့အကြုံ” ပါဝင်နေတယ် — ခွေးနဲ့ ဝံပုလွေ ဆင်တူတယ်ဆိုတာ သိထားတဲ့ အသိပညာမျိုး
Student က ဒီ soft answer တွေကို လိုက်မှတ်ရင်း teacher လောက် တော်လာတယ် — ဒါပေမယ့် အရွယ်အစားက အများကြီး သေးတယ်
ဒါကို “dark knowledge” လို့ ခေါ်တဲ့ လူတွေလည်း ရှိတယ် — စာအုပ်ထဲ တိုက်ရိုက် မရေးထားတဲ့ ဆရာ့ရဲ့ အတွေ့အကြုံ အသိပညာကိုး။
နေ့တိုင်း သုံးနေတဲ့ ဥပမာတွေ —
DistilBERT — Google ရဲ့ BERT ကို 40% သေးအောင် လုပ်ထားတာ၊ စွမ်းရည်က 97% လောက် ထိန်းထားနိုင်တယ်။ Hugging Face မှာ အသုံးအများဆုံး model တွေထဲက တစ်ခု
TinyLlama — Llama ကြီးရဲ့ အသေးစား version၊ laptop ပေါ်မှာ run လို့ရတယ်
Microsoft ရဲ့ Phi series — သေးပေမယ့် တော်တဲ့ model တွေ၊ distillation နည်းပညာ သုံးထားတယ်
ဘာလို့ အရေးကြီးတာလဲ —
ဖုန်းနဲ့ laptop ပေါ် run လို့ရတယ် — model ကြီးကြီးတွေက cloud server ပေါ်မှာပဲ run ရတာ
မြန်တယ် — parameter နည်းတော့ အဖြေထွက်တာ မြန်တယ်
စျေးသက်သာတယ် — API cost၊ server cost နည်းတယ်
Privacy ပိုကောင်းတယ် — ကိုယ့် device ပေါ်မှာပဲ run လို့ data အပြင် မထွက်ဘူး
သတိထားရမှာက — student က teacher ထက် ဘယ်တော့မှ မတော်ဘူး။ Teacher မှာ bias ရှိရင် student ဆီပါ ကူးသွားတယ်။ ပြီးတော့ distillation လုပ်ဖို့ အရင်ဆုံး teacher ကြီး ရှိရမယ် — အဲဒါ train ရတာ ငွေကုန်တယ်။
ကိုယ်တိုင် စမ်းချင်ရင် —
Hugging Face မှာ “distil” ဆိုတဲ့ နာမည်ပါတဲ့ model တွေ ရှာကြည့် — distilbert-base-uncased လိုမျိုး
Ollama နဲ့ tinyllama ကို run ကြည့်ပြီး ကြီးတဲ့ model နဲ့ ယှဉ်ကြည့် — ollama run tinyllama
ကိုယ့် app မှာ AI ထည့်ချင်ပေမယ့် server cost ကြောက်ရင် distilled model သေးသေးလေး သုံးတာ အကောင်းဆုံး ရွေးချယ်မှု
AI အကြီးကြီးတွေ သတင်းမှာ နေ့တိုင်း တွေ့နေရပေမယ့် တကယ့် နေ့စဉ်ဘဝထဲ ရောက်လာမှာက ဒီလို အသေးစား model လေးတွေပဲ။ ကြီးတာ မလိုဘူး — တော်ပြီး ကိုယ့်အိတ်ကပ်ထဲ ဝင်တာက အရေးကြီးတယ်။ 🙂