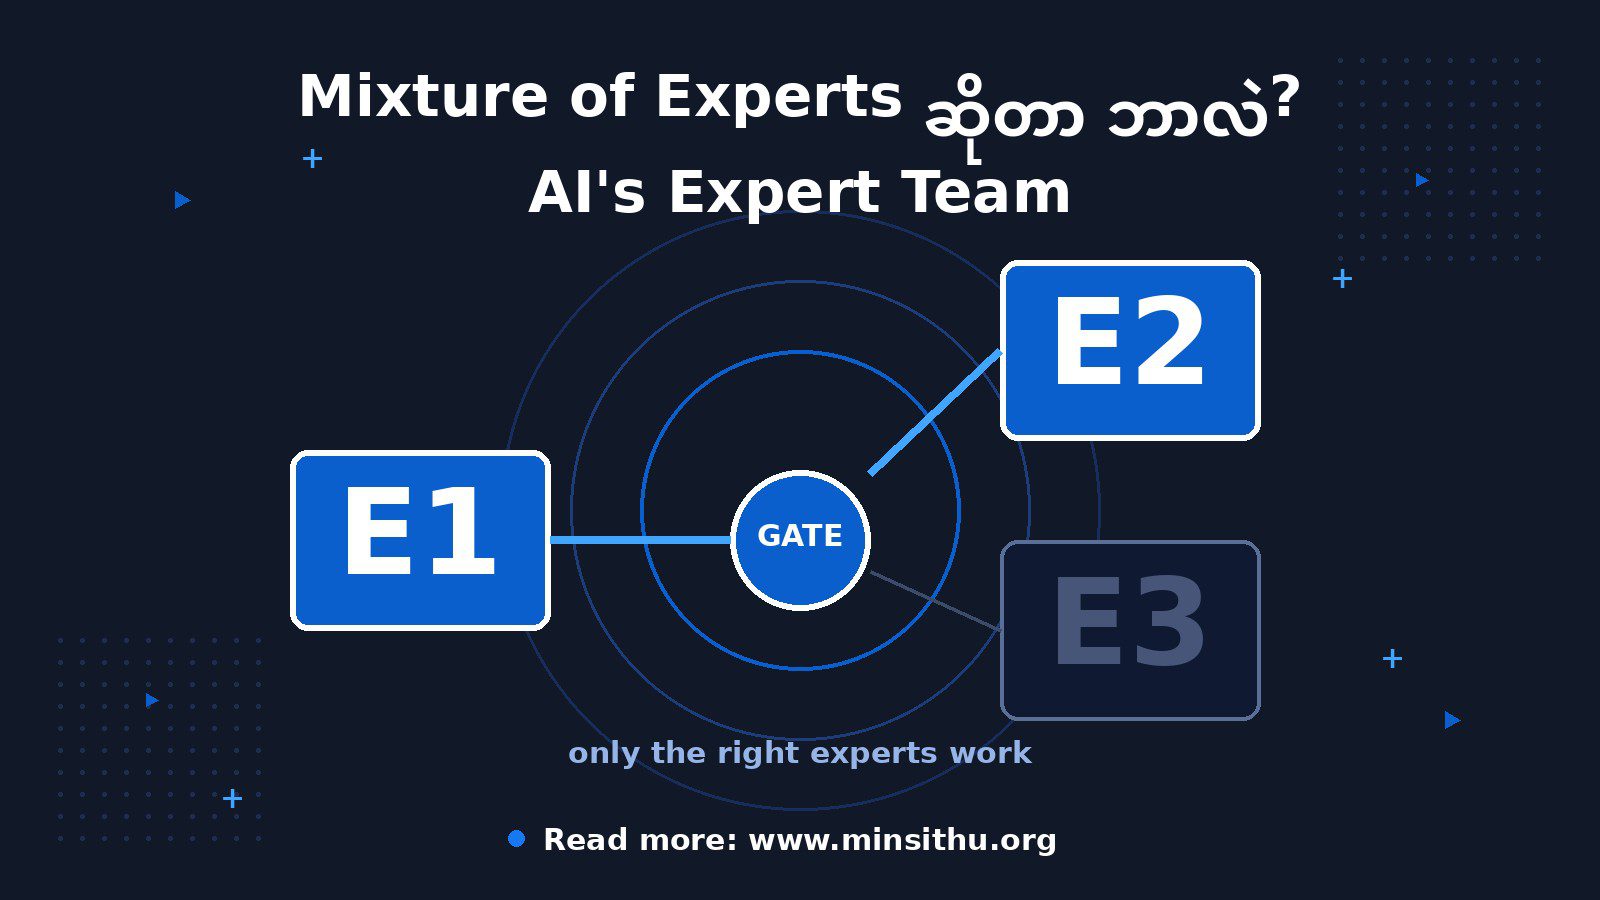
လွယ်လွယ်ပြောရင် Mixture of Experts (အတိုကောက် MoE) ဆိုတာ AI model ကြီးတစ်ခုကို “ဆရာဝန်အဖွဲ့” လို ဖွဲ့ထားတဲ့ နည်းလမ်း ပါ။ မေးခွန်းတစ်ခု ရောက်လာတိုင်း ဆရာဝန်အားလုံး ဝိုင်းမစဉ်းစားဘူး — ဒီမေးခွန်းနဲ့ အကိုက်ညီဆုံး ဆရာဝန် နှစ်ယောက် ဒါမှမဟုတ် သုံးယောက်ဆီကိုပဲ လွှဲပေးတယ်၊ သူတို့ပဲ ဖြေတယ်။
ဆေးရုံကြီးနဲ့ ဥပမာပေးရအောင်။ ဆေးရုံ reception ကို ဗိုက်နာတဲ့ လူနာ တစ်ယောက် ရောက်လာတယ် ဆိုပါစို့။ Reception က ဆရာဝန်အားလုံး (အရိုးအကြော၊ နှလုံး၊ အရေပြား၊ မျက်စိ…) ကို တစ်ယောက်ချင်း ခေါ်ပြီး “ဒီလူနာ ကြည့်ပေးပါ” လို့ မပြောဘူး။ ဗိုက်နာတာ ဆိုတော့ အစာအိမ် ဆရာဝန်ဆီ တိုက်ရိုက် လွှဲပေးတယ်။ MoE မှာလည်း အဲဒီအတိုင်းပဲ — စာတစ်ကြောင်း (token) ရောက်လာတိုင်း “gate” ဒါမှမဟုတ် “router” လို့ ခေါ်တဲ့ စနစ်လေးက ဒီ token ကို ဘယ် “expert” ဆီ ပို့ရမလဲ ဆုံးဖြတ်ပေးတယ်။ Expert တစ်ယောက်ချင်းစီက neural network အသေးစားလေး တစ်ခုစီ ဖြစ်ပြီး၊ ကိုယ်ကျွမ်းကျင်တဲ့ အပိုင်းပဲ ကိုင်တယ်။
ဒါကို နားလည်ဖို့ အရင်ဆုံး သိထားရမှာ “dense model” ဆိုတဲ့ အယူအဆ ပါ။ GPT လို model အဟောင်းတွေက dense — မေးခွန်းတစ်ခုကို ဖြေတိုင်း model ထဲက parameter အားလုံး တစ်ပြိုင်နက် အလုပ်လုပ်တယ်။ ဆရာဝန် ၁၀၀ ယောက် ရှိတဲ့ ဆေးရုံမှာ လူနာတစ်ယောက်အတွက် ဆရာဝန် ၁၀၀ လုံး ဝိုင်းစဉ်းစားသလိုပေါ့။ တိကျတယ်၊ ဒါပေမယ့် စျေးကြီးတယ် — ကွန်ပျူတာ အားလည်း အများကြီး သုံးရတယ်။
MoE က ဒီပြဿနာကို ဖြေရှင်းတယ်။ ဥပမာ Mixtral 8x7B ဆိုတဲ့ model မှာ expert ၈ ခု ပါတယ်။ ဒါပေမယ့် token တစ်ခုကို စဉ်းစားတိုင်း expert ၈ ခုလုံး မသုံးဘူး — gate က ရွေးပေးတဲ့ အကောင်းဆုံး ၂ ခုပဲ သုံးတယ်။ စုစုပေါင်း parameter က 47B လောက် ရှိပေမယ့် တကယ် အလုပ်လုပ်နေတာက 13B လောက်ပဲ။ နောက်ထပ် ဥပမာ — DeepSeek-V3 ဆိုရင် expert ၂၅၆ ခု ပါတယ်၊ တစ်ခါသုံး ၈ ခုပဲ။ စုစုပေါင်း 671B parameter ရှိပေမယ့် token တစ်ခုအတွက် 37B လောက်ပဲ အလုပ်လုပ်တယ်။
ဒါကြောင့် MoE ရဲ့ အားသာချက်က ရှင်းတယ် —
Parameter များများ (ဗဟုသုတ များများ) ကို compute နည်းနည်းနဲ့ သုံးလို့ ရတယ်။ Model ကြီးပေမယ့် ပြေးတာ မြန်တယ်၊ စျေးသက်သာတယ်
Expert တစ်ယောက်ချင်းစီက ကိုယ့်နယ်ပယ်မှာ ကျွမ်းကျင်လာတယ်။ ဥပမာ တစ်ယောက်က သင်္ချာ တော်တယ်၊ တစ်ယောက်က code တော်တယ်၊ တစ်ယောက်က ဘာသာစကား တော်တယ် — သဘာဝအတိုင်း ခွဲထွက်သွားတယ်
ဒါပေမယ့် အားနည်းချက်လည်း ရှိတယ်။ အကြီးဆုံးပြဿနာက “load balancing” — gate က expert တစ်ယောက်တည်းကိုပဲ အမြဲ ရွေးနေမိရင် ကျန်တဲ့ expert တွေ အားနေပြီး တစ်ယောက်တည်း ပင်ပန်းသလို ဖြစ်တယ်။ ဒါကို ကာကွယ်ဖို့ training လုပ်တုန်းမှာ expert အားလုံး မျှမျှတတ အလုပ်ရအောင် “auxiliary loss” ဆိုတဲ့ ဒဏ်ကြေးစနစ်လေး ထည့်ထားတယ်။ နောက်တစ်ချက်က memory — သုံးမယ့် expert ၂ ခုပဲ ဖြစ်ပေမယ့် expert ၈ ခုလုံးကို GPU memory ထဲ ထည့်ထားရတယ်။ ဆေးရုံ ဥပမာနဲ့ ပြောရင် လူနာတစ်ယောက်အတွက် ဆရာဝန် ၂ ယောက်ပဲ လိုပေမယ့် ဆရာဝန် ၈ ယောက်လုံးကို ဆေးရုံမှာ အလုပ်ခန့်ထားရသလိုပေါ့။
ကိုယ်နဲ့ ဘာဆိုင်လဲ ဆိုတော့ — ဒီနေ့ လူတွေ အခမဲ့/စျေးသက်သာစွာ သုံးနေတဲ့ open-weight model တော်တော်များများ (Mixtral, DeepSeek) က MoE နည်းနဲ့ တည်ဆောက်ထားတာ။ API စျေး ချိုသာနေတာရဲ့ နောက်ကွယ်မှာ ဒီနည်းပညာ ပါတယ်။ “Model ကြီးတယ်” ဆိုတိုင်း ကွန်ပျူတာ အားအများကြီး လိုတယ် မဟုတ်တော့ဘူး — ဘယ်နှယောက် အလုပ်လုပ်နေလဲ ဆိုတာက ပို အရေးကြီးတယ်။
မေးခွန်းတိုင်းကို လူတိုင်း ဝိုင်းမဖြေဘဲ ကျွမ်းကျင်သူကိုပဲ လွှဲတဲ့ ဆေးရုံစနစ် — ဒါပါပဲ MoE ဆိုတာ။ ရိုးရိုးလေး တွေးကြည့်ရင် သဘာဝကျတယ် မဟုတ်လား။ 🙂