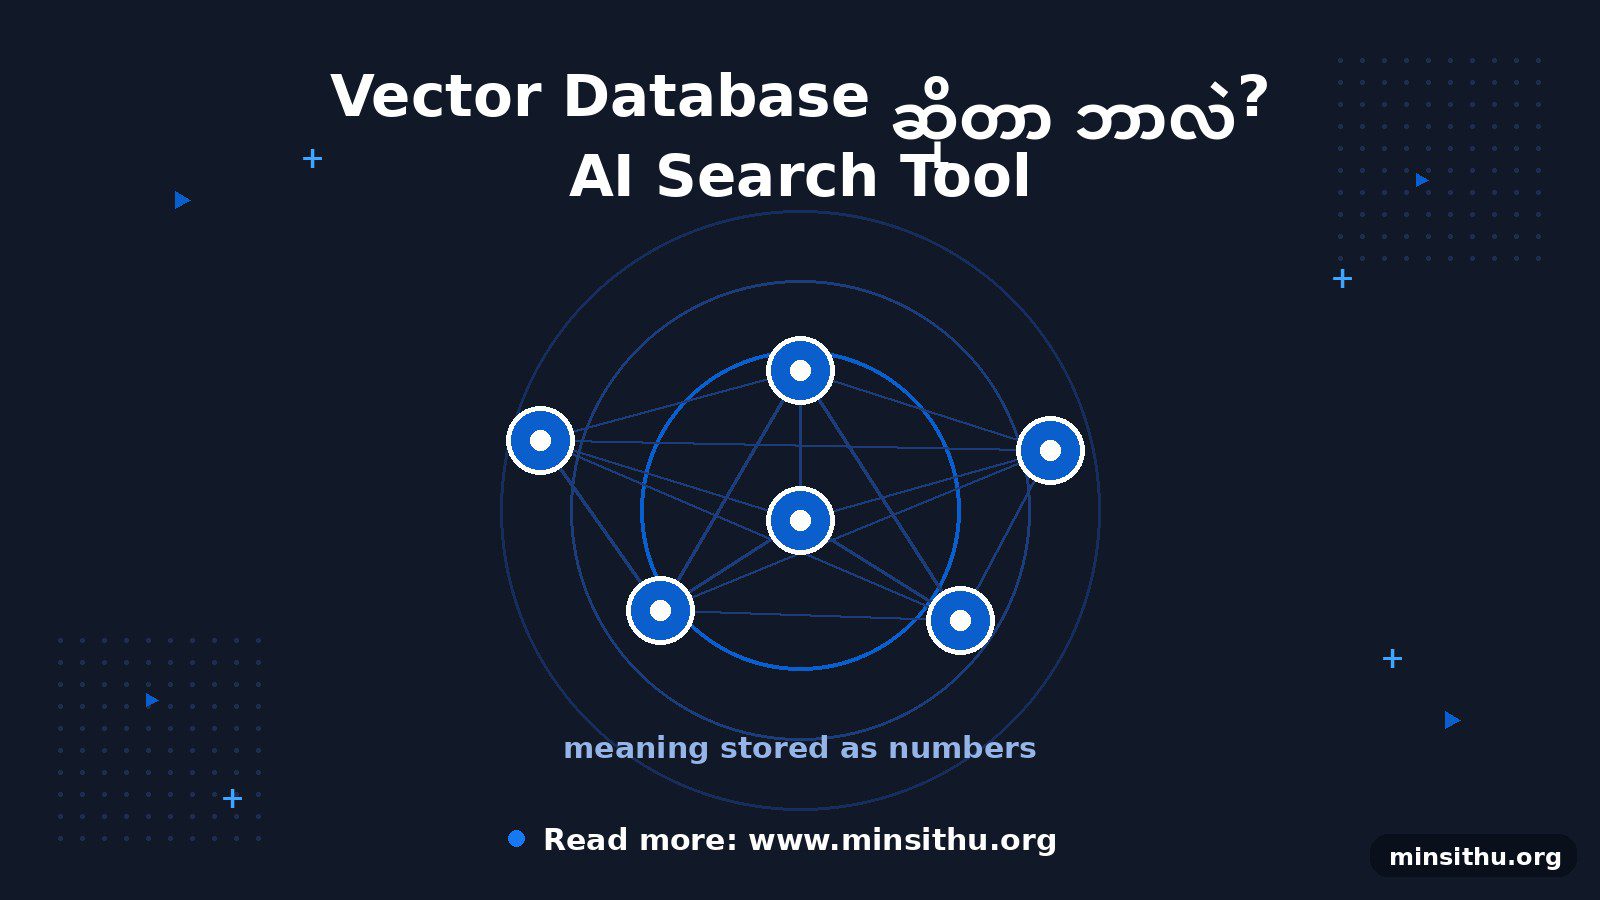
လွယ်လွယ်ပြောရရင် Vector Database ဆိုတာ စာသားတွေကို စာလုံးအတိုင်း မရှာဘဲ၊ အဓိပ္ပာယ်တူတာ နီးတာ ကို ရှာပေးတဲ့ database တစ်မျိုးပါ။ ပုံမှန် database က “နာမည် အတိအကျတူတာ ရှာ” ဆိုမှ ရတယ်။ Vector Database ကတော့ “အဓိပ္ပာယ် နီးစပ်တာ ရှာ” လို့ ပြောလို့ရတယ်။
စာကြည့်တိုက်တစ်အုပ်ကို စဉ်းစားကြည့်ပါ။
ပုံမှန်စာကြည့်တိုက်မှာ စာအုပ်တွေကို နာမည်အက္ခရာစဉ်အတိုင်း စီထားတယ်။ “Python” ဆိုတဲ့ စာအုပ်လိုချင်ရင် P အကွက်ကို သွားရှာရတယ်။ ဒါပေမယ့် ကိုယ်က “Programming သင်ချင်တယ်” လို့ ပြောရင် စာကြည့်တိုက်မှူးက Python စာအုပ်တင်မကဘူး၊ Java စာအုပ်၊ Coding အခြေခံစာအုပ်တွေပါ နီးစပ်ရာတွေ ယူပေးတတ်တယ်။ ဘာလို့လဲဆိုတော့ သူက စာအုပ်နာမည်ကို မဟုတ်ဘဲ၊ အကြောင်းအရာကို နားလည်လို့ပါ။
Vector Database က အဲဒီစာကြည့်တိုက်မှူးလိုပဲ။
AI က စာတစ်ပိုဒ်ကို ဖတ်ပြီး အဲဒီစာရဲ့ အဓိပ္ပာယ်ကို ကိန်းဂဏန်း အများကြီး (vector) အဖြစ် ပြောင်းလိုက်တယ်။ ဒါကို Embedding လို့ ခေါ်တယ် — အရင်က ကျွန်တော် ရေးဖူးတယ်။ ပြီးရင် အဲဒီကိန်းတွေကို Vector Database ထဲ သိမ်းထားတယ်။ နောက်တစ်ခါ ကိုယ်က မေးခွန်းတစ်ခု မေးလိုက်ရင် AI က မေးခွန်းကိုလည်း vector ပြောင်းပြီး၊ database ထဲမှာ အနီးဆုံး vector တွေကို ရှာထုတ်ပေးတယ်။ အနီးဆုံးဆိုတာ အဓိပ္ပာယ် အနီးဆုံးပဲ။
ဥပမာ ကိုယ်က customer support chatbot တစ်ခု ဆောက်တယ်ဆိုပါစို့။ ကုမ္ပဏီရဲ့ စာရွက်စာတမ်း အမျိုး ၅၀၀ လောက် ရှိတယ်။ User က “ပစ္စည်း ပြန်လဲချင်ရင် ဘယ်နှရက် အတွင်းလဲ?” လို့ မေးတယ်။ စာရွက်ထဲမှာ “Return Policy: 14 days” လို့ ရေးထားတာ ရှိတယ်။ စာလုံးချင်း မတူပေမယ့် အဓိပ္ပာယ်က ဆက်စပ်နေတယ်။ Vector Database က အဲဒီစာပိုဒ်ကို ရှာတွေ့ပြီး AI ကို ပေးလိုက်တယ်။ AI က အဲဒါကို ဖတ်ပြီး “14 ရက်အတွင်း ပြန်လဲလို့ရပါတယ်” လို့ ဖြေတယ်။ ဒါက RAG လို့ ခေါ်တဲ့ စနစ်ရဲ့ အဓိက အစိတ်အပိုင်းပဲ။
ဘာတွေ သုံးကြလဲ ဆိုရင် –
Pinecone — cloud ပေါ်မှာ အလွယ်တကူ သုံးလို့ရတယ်၊ beginner အတွက် အဆင်ပြေတယ်
Qdrant — open source၊ ကိုယ့် server ပေါ်မှာ run လို့ရတယ်
Chroma — သေးသေးလေးနဲ့ စမ်းဖို့ ကောင်းတယ်၊ Python နဲ့ တွဲသုံးရတာ လွယ်တယ်
pgvector — PostgreSQL သုံးနေကျဆိုရင် extension တစ်ခု ထည့်ရုံပဲ
ပုံမှန် database နဲ့ ဘာကွာလဲ ဆိုတော့ ရှာတဲ့နည်း ကွာတယ်။ ပုံမှန် database က keyword တူမှ တွေ့တယ်။ “ကား” လို့ ရှာရင် “မော်တော်ယာဉ်” လို့ ရေးထားတဲ့ စာကို မတွေ့ဘူး။ Vector Database ကတော့ ကိန်းဂဏန်း အကွာအဝေးနဲ့ တိုင်းတာမို့လို့ အဓိပ္ပာယ်တူရင် စာလုံး မတူလည်း တွေ့တယ်။
တစ်ခုတော့ သတိထားရမယ်။ Vector Database က ပညာရှိ မဟုတ်ဘူး၊ အနီးစပ်ဆုံး ရှာပေးတဲ့ ကိရိယာပဲ။ သိမ်းထားတဲ့ စာတွေကိုယ်တိုင်က မှားနေရင် အဖြေလည်း မှားမှာပဲ။ ပြီးတော့ vector တွေ ဖန်တီးတဲ့ embedding model ကို ကောင်းကောင်း ရွေးရတယ် — မြန်မာစာ အတွက်ဆိုရင် မြန်မာစာ ကောင်းကောင်း နားလည်တဲ့ model မှ အဆင်ပြေမယ်။
ကိုယ်က AI app တစ်ခု ဆောက်ဖို့ စိတ်ကူးနေရင် Vector Database ဆိုတာ မဖြစ်မနေ သိထားရမယ့် အပိုင်းတစ်ခု ဖြစ်လာပြီ။ ခက်ခက်ခဲခဲ မဟုတ်ပါဘူး၊ စာကြည့်တိုက်မှူး ကောင်းကောင်းတစ်ယောက် ငှားထားသလိုပဲ မှတ်ထားလိုက်ပါ။ 🙂