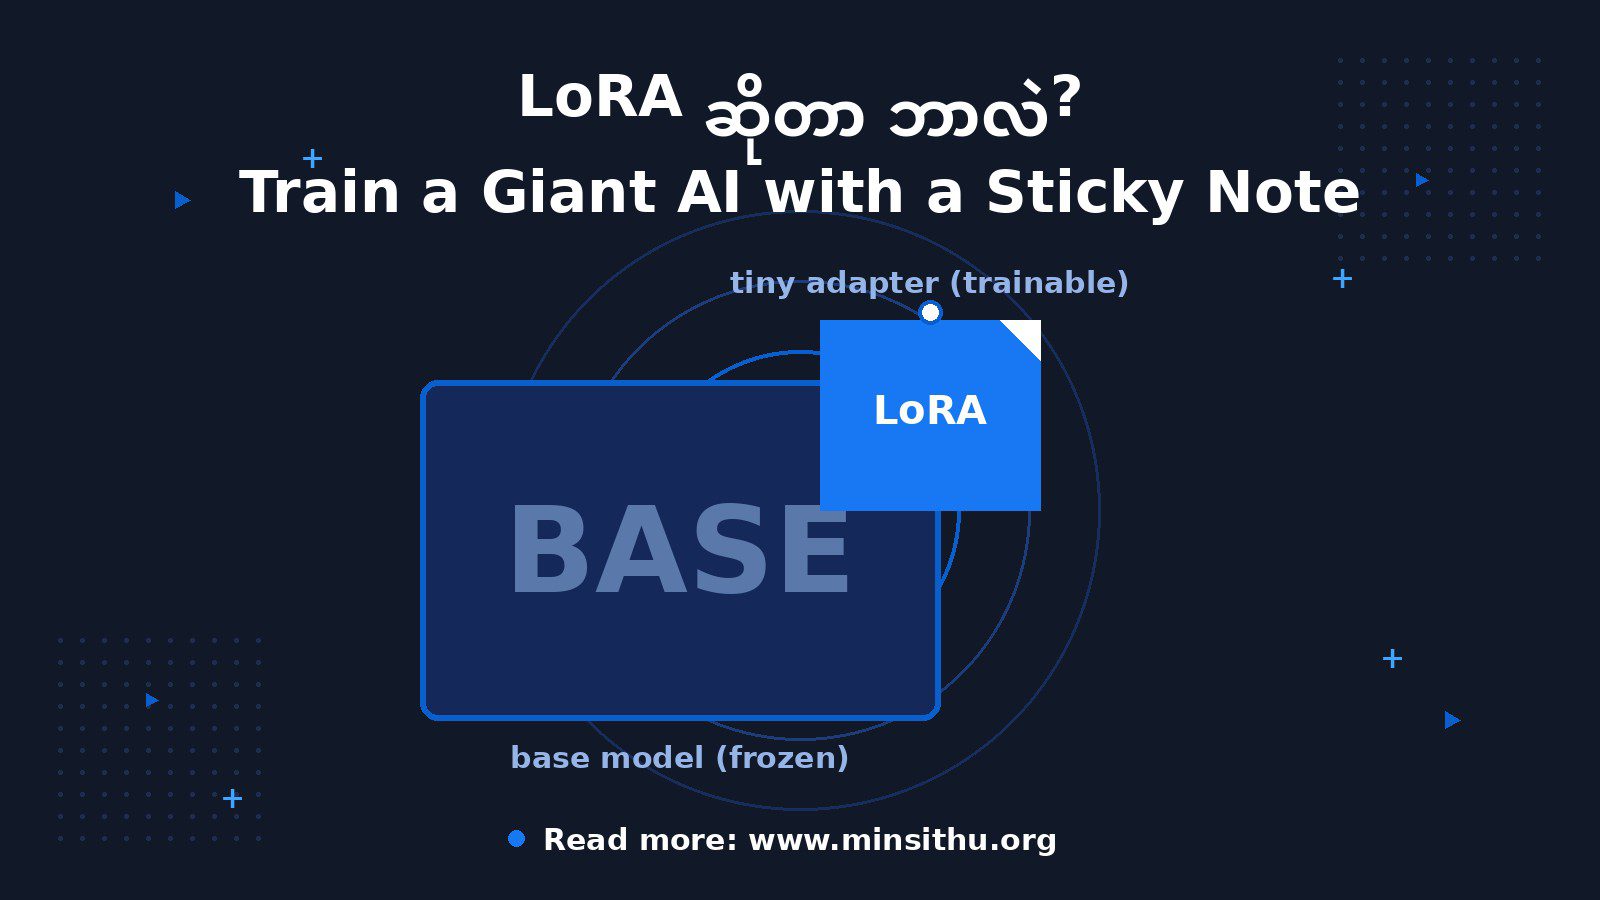
လွယ်လွယ်ပြောရရင် LoRA ဆိုတာ AI model အကြီးကြီးတစ်ခုကို ကိုယ့်စိတ်ကြိုက် ချိန်ညှိချင်တာ — ဒါပေမယ့် model တစ်ခုလုံးကို ပြန် train ရမယ့် ကုန်ကျစရိတ် အကြီးကြီး မခံဘဲ၊ အသေးစား “adapter” လေးတစ်ခုကိုပဲ train တဲ့ နည်းလမ်းပါ။
စာအုပ်အထူကြီးတစ်အုပ်နဲ့ ဥပမာ ပြောရအောင်။ စာမျက်နှာ ၁၀၀၀ လောက်ရှိတဲ့ စာအုပ်တစ်အုပ်ကို ဖတ်ပြီးတော့ ကိုယ့်အတွက် အရေးကြီးတဲ့ အချက်လေးတွေ မှတ်ထားချင်တယ်ဆိုပါစို့။ စာအုပ်တစ်ခုလုံး ပြန်ရိုက်စရာ မလိုဘူးလေ — စာမျက်နှာတွေကြားမှာ sticky note လေးတွေ ကပ်လိုက်ရုံပဲ။ မူရင်းစာအုပ်က အတိုင်းပဲ ရှိနေတယ်၊ ကိုယ့်မှတ်စုလေးတွေက အပေါ်ကနေ ကပ်ထားတာ။ LoRA ကလည်း ဒီအတိုင်းပဲ။ Base model (ဥပမာ Llama 3.1) ကို လုံးဝ မထိဘူး — သူ့ဘေးမှာ သေးသေးလေးဖြစ်တဲ့ adapter တစ်ခုကို train ပြီး ကပ်ထားလိုက်တာ။
ဒါဆို သာမန် fine-tuning နဲ့ ဘာကွာလဲဆိုတော့ — full fine-tuning ဆိုရင် model ရဲ့ parameter အားလုံး (Llama 8B ဆို ၈ ဘီလီယံ) ကို ပြန် train ရတာ။ VRAM ၄၀-၈၀GB လောက် လိုတယ်။ A100 GPU လို စက်ကြီးတွေ မရှိရင် စဉ်းစားလို့တောင် မရဘူး။ LoRA ကျတော့ base model ရဲ့ weight တွေအားလုံးကို “freeze” လုပ်ထားတယ် — မရွေ့ဘူး။ အစားထိုးပြီး train တာက rank နိမ့်တဲ့ matrix သေးသေးလေး နှစ်ခုပဲ။ Train လုပ်ရတဲ့ parameter က စုစုပေါင်းရဲ့ ၀.၁% လောက်ပဲ ရှိတယ်။
ဥပမာ တကယ့်အခြေအနေနဲ့ ပြောရအောင်။ ကျွန်တော် AI model တစ်ခုကို မြန်မာလို ဖြေတတ်အောင် သင်ချင်တယ်ဆိုပါစို့။ Llama 3.1 8B ကို full fine-tuning လုပ်ရင် cloud GPU ငှားခ ဒေါ်လာရာချီ ကုန်မယ်။ LoRA နဲ့ဆို ကိုယ့် PC ထဲက RTX 3090 တစ်ကဒ်တည်းနဲ့ လုပ်လို့ရတယ်။ Train ပြီးသွားတဲ့ adapter file က MB ရာဂဏန်းလောက်ပဲ ရှိတယ် — base model က GB များစွာ ရှိပေမယ့်။ Adapter ကို ဖြုတ်ထားရင် မူရင်း model အတိုင်း ပြန်ရတယ်။ အဲဒါ LoRA ရဲ့ အလှပဲ။
QLoRA ဆိုတာလည်း ရှိသေးတယ်။ ဒါက LoRA ရဲ့ ပိုချွေတာတဲ့ ဗားရှင်း — base model ကို 4-bit quantization နဲ့ memory ထဲ တင်ထားပြီး LoRA adapter ပဲ train တာ။ (Quantization အကြောင်း မနေ့က ရေးထားတဲ့ post မှာ ရှင်းပြထားတယ်။) QLoRA နဲ့ဆို 65B လောက်ရှိတဲ့ model ကြီးကိုတောင် GPU တစ်ကဒ်တည်းနဲ့ fine-tune လုပ်လို့ရတယ်လို့ သူ့ paper မှာ ပြောထားတယ်။ ၂၀၂၃ က ထွက်တုန်းက လူတိုင်း အံ့ဩသွားတဲ့ နည်းပညာပဲ။
ကိုယ်တိုင် စမ်းကြည့်ချင်ရင် —
unsloth ဆိုတဲ့ free tool ကနေ စပါ။ Google Colab notebook တွေ အဆင်သင့် ပေးထားတယ် — unsloth လို့ GitHub မှာ ရှာလိုက်ရုံပဲ
ကိုယ် သင်ချင်တဲ့ data ကို ပြင်ဆင်ပါ။ ဥပမာ မြန်မာလို မေးခွန်း-အဖြေ ၅၀၀ လောက် CSV ဒါမှမဟုတ် JSONL file လုပ်
Unsloth notebook ထဲမှာ base model (ဥပမာ llama-3.1-8b) ရွေး၊ ကိုယ့် dataset တင်၊ Train နှိပ်
Train ပြီးရင် ရလာတဲ့ adapter ကို Ollama မှာ သုံးချင်ရင် ollama create နဲ့ modelfile ထဲ adapter လမ်းကြောင်း ထည့်ပြီး run လို့ရ
အရင်ဆုံး သေးသေးလေး စမ်းပါ — dataset ၁၀၀ လောက်နဲ့ train ကြည့်ပြီး အဖြေပြောင်းတာ တွေ့ရင် ဆက်တိုး
သတိထားရမှာတစ်ခုက LoRA က အစွမ်းထက်ပေမယ့် မှော်ပညာ မဟုတ်ဘူး။ Base model မသိတဲ့ အရာကို အသစ်အဆန်း သင်ပေးလို့မရဘူး — ရှိပြီးသား အသိပညာကို ကိုယ့်ပုံစံ၊ ကိုယ့်ဘာသာစကားနဲ့ ပြန်ပြောတတ်အောင် ချိန်တာပဲ။ လုံးဝ အသစ်အဆန်း သင်ချင်ရင်တော့ data အများကြီးနဲ့ full training လိုတယ်။
GPU တစ်ကဒ်တည်းနဲ့ AI အကြီးကြီးကို ကိုယ့်ဘာသာ ချိန်ညှိလို့ရတဲ့ ခေတ် ရောက်နေပြီဆိုတာ တော်တော် မိုက်တယ်လို့ ကျွန်တော် ထင်တယ်။ အရင်က ဒါမျိုး လုပ်နိုင်တာ lab ကြီးတွေပဲ။ အခု ကိုယ့်အခန်းထဲက PC နဲ့ လုပ်လို့ရနေပြီ။ 🙂