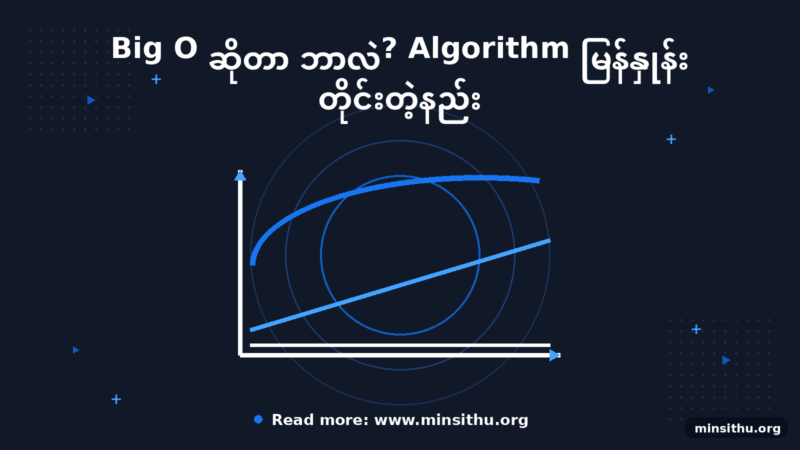
လွယ်လွယ်ပြောရရင် Big O ဆိုတာ Algorithm တစ်ခု ဘယ်လောက် မြန်လဲ၊ Data များလာရင် ဘယ်လောက်နှေးသွားမလဲ ဆိုတာကို တိုင်းတဲ့ ပေတံပါ။ Code ရေးတဲ့အခါ “အလုပ်ဖြစ်တယ်” ဆိုတာနဲ့ မလုံလောက်ဘူး။ Data ၁၀ ခု နဲ့ အလုပ်ဖြစ်ပေမယ့် Data သိန်းချီ ရောက်လာရင် ဆာဗာက ပြိုကျသွားနိုင်တယ်။
ဥပမာ ပြောရရင် စာရွက်တစ်ထုပ်ထဲက နာမည်တစ်ခု ရှာတာနဲ့ တူတယ်။ စာရွက်တွေကို တစ်ရွက်ချင်း လှန်ရှာရင် Data များလေ ကြာလေပဲ။ ဒါကို O(n) လို့ ခေါ်တယ် — n က Data အရေအတွက်။ ဒါပေမယ့် နာမည်တွေကို A-Z စီထားပြီး အလယ်ကနေ ခွဲရှာရင် (Binary Search) Data နှစ်ဆတိုးလည်း အချိန်က နည်းနည်းပဲ ပိုကြာတယ်။ ဒါကို O(log n) လို့ ခေါ်တယ်။
အတွေ့ရများတဲ့ Big O အမျိုးအစားတွေက —
– O(1) → Data ဘယ်လောက်များများ အချိန်အတူတူပဲ (ဥပမာ Array ထဲက Index နဲ့ ဆွဲထုတ်တာ)
– O(log n) → Data များလာလည်း နည်းနည်းပဲ ပိုကြာတယ် (Binary Search)
– O(n) → Data များသလောက် အချိန်ပိုကြာတယ် (တစ်ခန်းချင်း Loop ပတ်တာ)
– O(n²) → Loop ထဲမှာ Loop ထပ်ပတ်တာ — Data များရင် အရမ်းနှေးတယ်
လက်တွေ့မှာ ဘာကွာလဲဆိုရင် Data ၁ သန်း ရှိတယ်ဆိုပါစို့။ O(n) ဆို အဆင့် ၁ သန်း လုပ်ရတယ်။ O(log n) ဆို အဆင့် ၂၀ လောက်ပဲ။ ကွာခြားချက်က ကြီးမားတယ်။
Beginner တွေ အနေနဲ့ အရင်ဆုံး သတိထားရမှာက Nested Loop ပါ။ Loop ထဲမှာ Loop ထပ်ရေးမိရင် O(n²) ဖြစ်သွားတတ်တယ်။ အဲဒါကို သတိထားပြီး ရှောင်နိုင်ရင် တော်တော်လေး တိုးတက်ပြီ။
Big O ကို လေ့လာတာက Interview အတွက်တင် မဟုတ်ဘူး။ တကယ့် Production မှာ User သန်းချီ သုံးတဲ့အခါ Algorithm ရွေးချယ်မှု မှားရင် Server Bill က တက်လာမှာ၊ User တွေက စောင့်ရတာ ကြာမှာ။ ပေတံမှန်မှန် ကိုင်တတ်ဖို့ အရေးကြီးတယ်။ 🙂
– Min SiThu (www.minsithu.org)