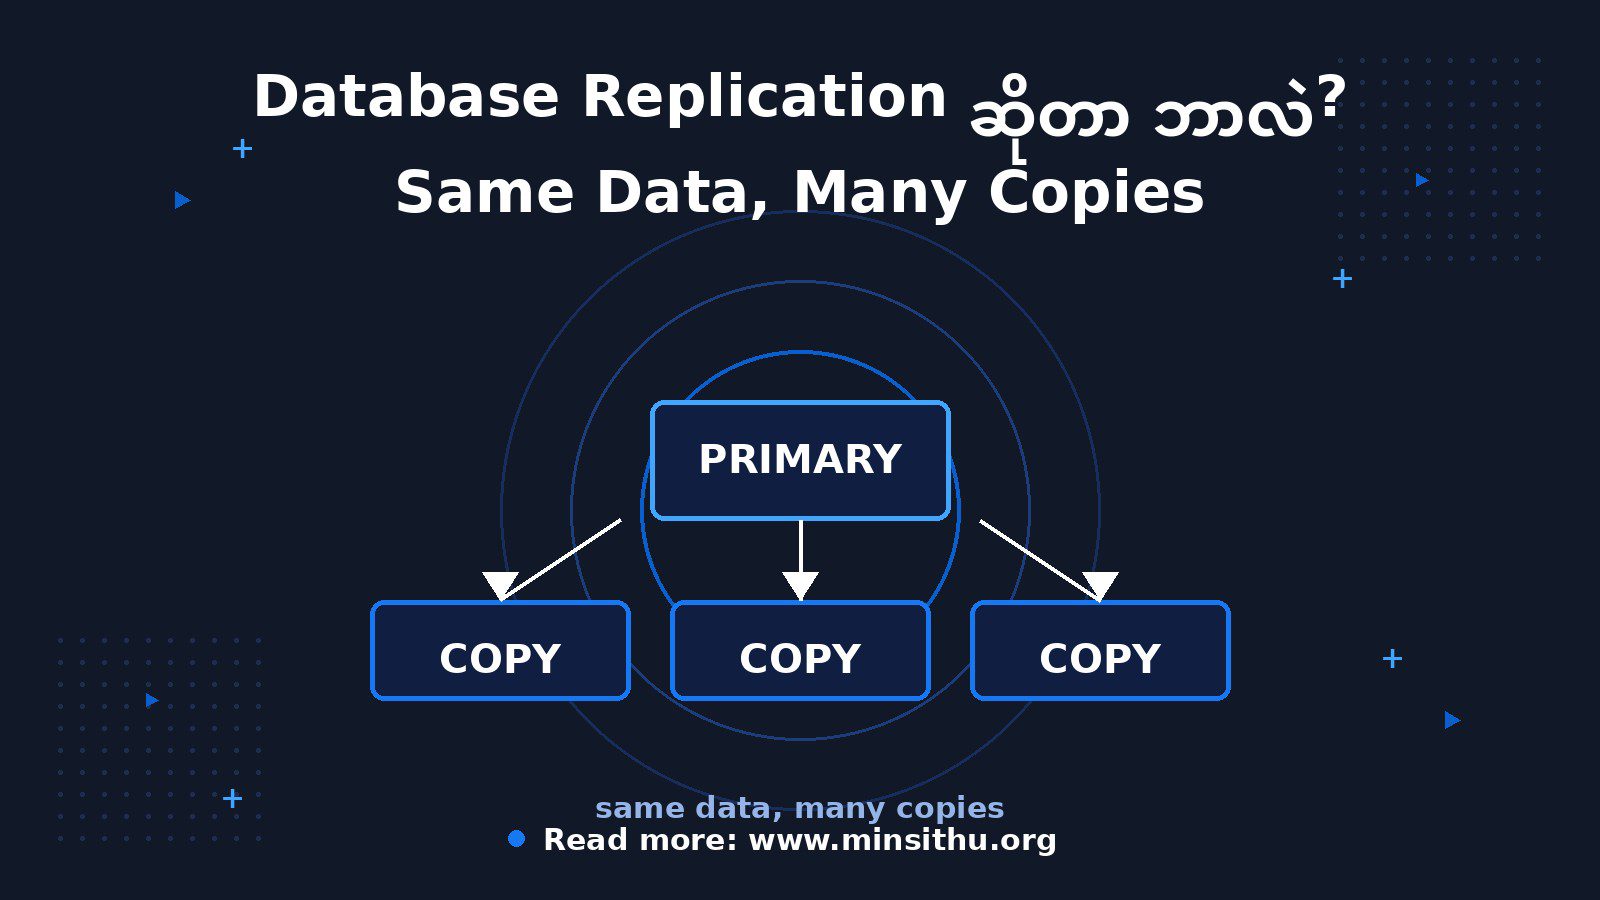
လွယ်လွယ်ပြောရရင် Database Replication ဆိုတာ ဒေတာတစ်ခုတည်းကို Database အများကြီးမှာ မိတ္တူပွားထားတဲ့နည်းပါ။ အဓိက Database (Primary) မှာ ပြောင်းလဲတာမှန်သမျှကို တခြား Database (Replica) တွေဆီ အလိုလို ကူးပေးတယ်။ ဒါကြောင့် Database တစ်ခုကျသွားလည်း ဒေတာမပျောက်ဘူး၊ လူများလည်း မြန်မြန် ဖတ်လို့ရတယ်။
ကျွန်တော် ဒါကို နားလည်သွားတာ စာအုပ်ဆိုင်နဲ့ ယှဉ်ကြည့်မိတော့မှ ဖြစ်တယ်။ စာအုပ်တစ်အုပ်တည်းကို ဆိုင်တစ်ဆိုင်တည်းမှာပဲ ထားရင်၊ အဲဒီဆိုင်ပိတ်သွားရင် ဘယ်သူမှ ဖတ်လို့မရတော့ဘူး။ ဒါပေမယ့် တူညီတဲ့စာအုပ်ကို ဆိုင်ခွဲတွေမှာပါ တင်ထားရင်၊ ဆိုင်တစ်ဆိုင်ပိတ်လည်း ကျန်တဲ့ဆိုင်တွေမှာ ဖတ်လို့ရတယ်။ Replication က အဲဒီစာအုပ်ဆိုင်ခွဲတွေနဲ့ အတူတူပဲ — ဒေတာကို နေရာအများကြီးမှာ ထားတာ။
Replication က ဘယ်လိုအလုပ်လုပ်တာလဲ?
အခြေခံပုံစံက ဒီလိုပါ။ Primary Database တစ်ခုရှိတယ်။ အဲဒါက စာရေးတဲ့အလုပ်ကို ကိုင်တယ် — User အသစ်စာရင်းသွင်းတာ၊ Order အသစ်တင်တာ၊ Post အသစ်ရေးတာမျိုးပေါ့။ Replica Database တွေက Primary မှာ ဖြစ်သွားတဲ့ ပြောင်းလဲမှုတွေကို လိုက်ကူးတယ်။
Primary က ပြောင်းလဲမှုကို Log ထဲမှာ မှတ်တယ် — PostgreSQL မှာ WAL (Write-Ahead Log) လို့ ခေါ်တယ်၊ MySQL မှာ Binary Log လို့ ခေါ်တယ်။ ပြောင်းလဲမှုတိုင်းကို စာရင်းမှတ်ထားတာပေါ့။
Replica တွေက အဲဒီ Log ကို ဖတ်ပြီး ကိုယ့်ဒေတာထဲမှာ တူညီတဲ့ပြောင်းလဲမှုကို ပြန်လုပ်တယ်။ ဒီလိုနဲ့ Replica က Primary နဲ့ အမြဲတမ်း တစ်ထပ်တည်းနီးပါး ဖြစ်နေတယ်။
User တွေက စာဖတ်တဲ့အခါ Replica ကနေ ဖတ်လို့ရတယ်။ ဥပမာ Website ကို လူ ၁၀၀၀၀ လောက် တစ်ပြိုင်နက် ကြည့်နေရင်၊ အားလုံးကို Primary တစ်ခုတည်းက ဖြေပေးစရာမလိုတော့ဘူး။ Replica တွေက ခွဲယူဖြေပေးတယ်။
ဒီလိုလုပ်တာကို Read Scaling လို့ ခေါ်တယ်။ စာရေးတာက Primary တစ်ခုတည်းမှာ၊ စာဖတ်တာကိုတော့ Replica အများကြီးမှာ ခွဲယူတယ်။
Synchronous နဲ့ Asynchronous
Replication မှာ ပုံစံနှစ်မျိုးရှိတယ်။ ကွာခြားချက်က Replica ကို စောင့်မလား၊ မစောင့်ဘူးလား ဆိုတာပဲ။
Synchronous Replication ဆိုတာ Primary က ပြောင်းလဲမှုကို Replica အနည်းဆုံးတစ်ခုဆီ ရောက်တာ သေချာမှ “ပြီးပြီ” လို့ ပြန်ပြောတာ။ အားသာချက်က ဒေတာ ဘယ်တော့မှ မကွာဘူး။ အားနည်းချက်က Replica နှေးနေရင် Primary လည်း နှေးသွားတယ်။ ဘဏ်လို ဒေတာတစ်ခုမှ မပျောက်ရတဲ့နေရာတွေမှာ ဒီနည်းကို သုံးတယ်။
Asynchronous Replication ဆိုတာ Primary က ပြောင်းလဲမှုကို လုပ်ပြီးတာနဲ့ ချက်ချင်း “ပြီးပြီ” လို့ ပြန်ပြောတယ်။ Replica ဆီကို ကူးတာက နောက်မှ လိုက်လုပ်တယ်။ အားသာချက်က မြန်တယ်။ အားနည်းချက်က Primary ကျသွားတဲ့အချိန်မှာ Replica က ပြောင်းလဲမှုအသစ်တွေ မကူးရသေးရင် ဒေတာ နည်းနည်း ဆုံးရှုံးနိုင်တယ်။ ဒါကို Replication Lag လို့ ခေါ်တယ်။ Website အများစုက ဒီနည်းကို သုံးတယ် — မြန်တာကို ဦးစားပေးလို့။
Failover နဲ့ တွဲသုံးတာ
Replication ရဲ့ အကြီးမားဆုံး အကျိုးတစ်ခုက Primary ကျရင် Replica ကို အစားထိုးခန့်လို့ရတာပါ။ ဒါကို Failover လို့ ခေါ်တယ်။ Primary Server မီးပျက်သွားရင်၊ ဒါမှမဟုတ် Database ကို Update တင်ရင်း ကျသွားရင်၊ Replica တစ်ခုကို Primary အသစ်အဖြစ် မြှင့်ပေးလိုက်တယ်။ User တွေက ခဏလေး ဆက်တိုက်မရတာကလွဲပြီး ဒေတာ မပျောက်ဘူး၊ Site လည်း ကြာကြာ မကျဘူး။
ဒါပေမယ့် Failover က အလိုလို ဖြစ်ဖို့အတွက် စနစ်တကျ စီစဉ်ထားဖို့လိုတယ်။ ဘယ် Replica ကို မြှင့်မလဲ၊ App တွေက Database အသစ်ကို ဘယ်လိုရှာမလဲ ဆိုတာတွေ ကြိုတင်ပြင်ထားရတယ်။ ဒီအပိုင်းကို သေချာမလုပ်ထားရင် Failover က လက်နဲ့ လုပ်ရတဲ့ အလုပ်ဖြစ်သွားပြီး အချိန်ကြာသွားတယ်။
Replication နဲ့ Backup က မတူဘူး
လူတော်တော်များများ ရောတတ်တာက Replication ကို Backup လို့ ထင်တာပါ။ မတူဘူး။
Replication က အချိန်နဲ့တပြေးညီ မိတ္တူပါ။ Primary မှာ ဒေတာ အမှားနဲ့ ဖျက်မိရင် အဲဒီအမှားကလည်း Replica တွေဆီ ကူးသွားတယ်။ ဖျက်မိတဲ့ Table က Replica မှာလည်း ပျောက်သွားတယ်။
Backup က အချိန်တစ်ခုက ဒေတာရဲ့ ပုံရိပ်ပါ။ မနေ့က Backup ရှိရင် မနေ့က ဒေတာကို ပြန်ယူလို့ရတယ်။ ဖျက်မိတာကို ပြန်ပြင်လို့ရတယ်။
ဒါကြောင့် Replication ရှိလည်း Backup လိုတယ်။ Replication က Server ကျတာကို ကာတယ်၊ Backup က လူမှားတာကို ကာတယ်။ နှစ်ခုလုံးလိုတယ်။
ဒါကိုသိထားရင် နောက်တစ်ခါ “Site က လူများလည်း မကျဘူး၊ Server ကျလည်း ဒေတာမပျောက်ဘူး” လို့ ကြားရင် နောက်ကွယ်မှာ Replication အလုပ်လုပ်နေတယ်ဆိုတာ သတိရလိမ့်မယ်။ ဒေတာကို နေရာတစ်ခုတည်းမှာ မထားဘဲ နေရာအများကြီးမှာ ပွားထားတဲ့ အတွေးလေးပဲ။ 🙂