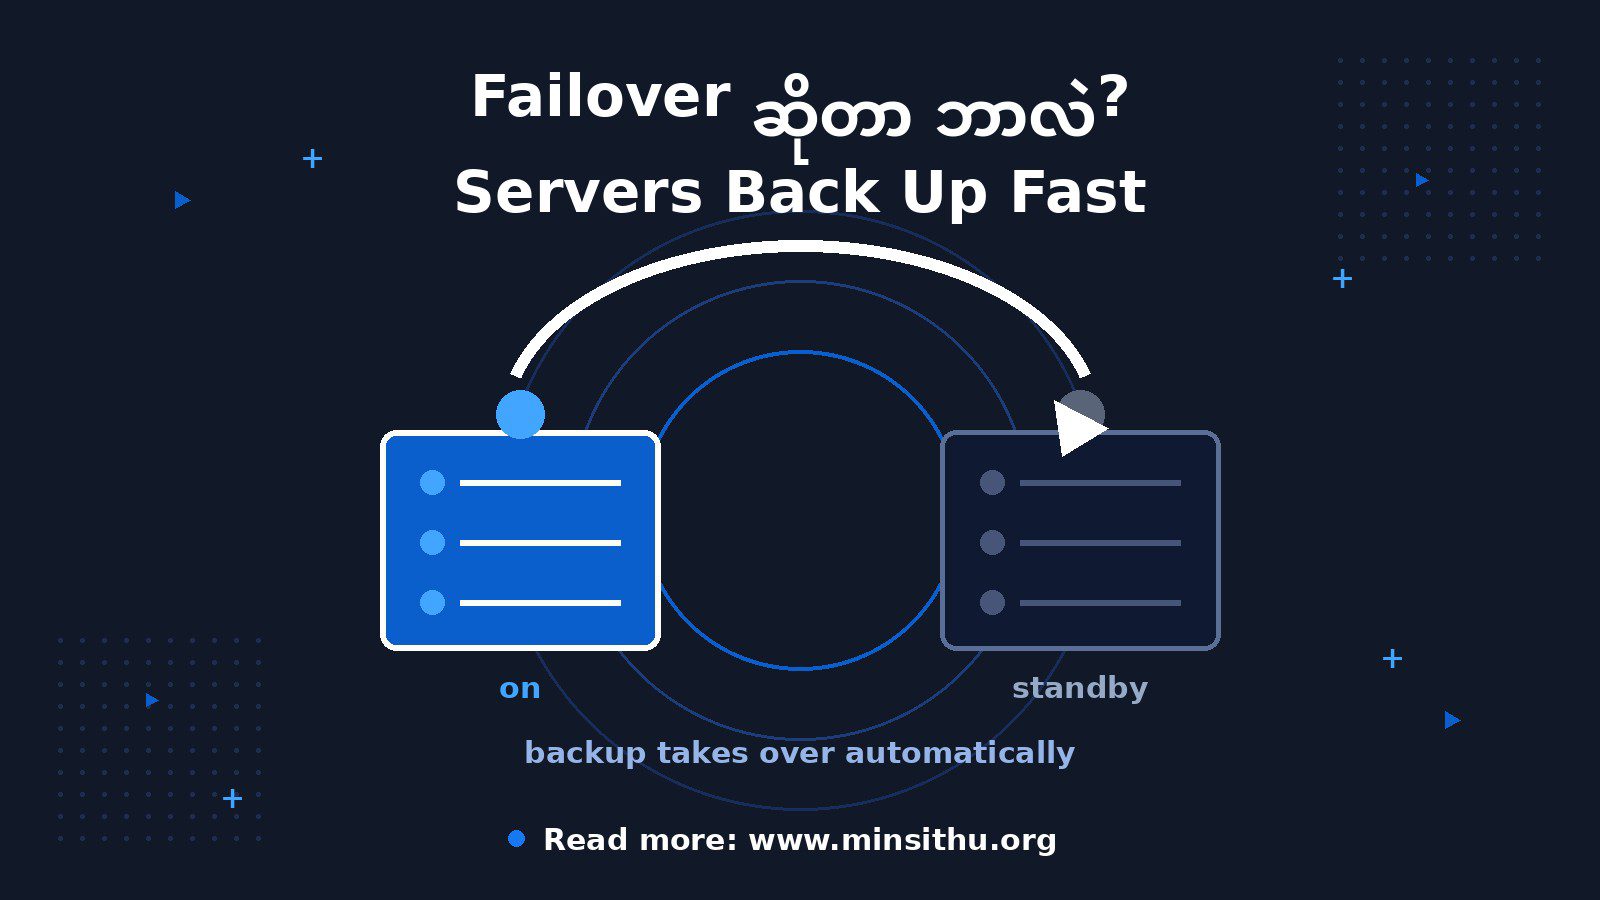
လွယ်လွယ်ပြောရရင် Failover ဆိုတာ အဓိက server ပျက်သွားတဲ့အခါ အရံအသင့် server က အလိုလို တာဝန်ယူလိုက်တဲ့ စနစ်ပါ။ Website တစ်ခု 24 နာရီ မပြတ်တမ်း လည်ပတ်နေဖို့ ဒီနည်းကို သုံးတယ်။ ကိုယ်တို့ သုံးနေတဲ့အချိန်မှာ server တစ်လုံး ပျက်သွားတာ ကိုယ် မသိလိုက်ဘူး။
ဇာတ်ပွဲမှာ မင်းသားအရံ (understudy) ထားသလိုပဲ စဉ်းစားကြည့်ပါ။
ပြဇာတ်ရုံမှာ မင်းသားအဓိက နေမကောင်းဖြစ်သွားရင် ပွဲကို ရပ်ပစ်လို့ မရဘူး — လက်မှတ်ဝယ်ထားတဲ့ ပရိသတ် အပြည့် ထိုင်နေတယ်။ ဒါကြောင့် မင်းသားအရံ တစ်ယောက် အမြဲ အသင့်ပြင်ထားတယ်။ အဓိက ထွက်မလာနိုင်တာနဲ့ အရံက စင်ပေါ်တက်ပြီး ပွဲ ဆက်ကတယ်။ ပရိသတ်တောင် သတိမထားမိဘူး။ Failover လည်း ဒီလိုပဲ — အဓိက server “နေမကောင်း” ဖြစ်တာနဲ့ အရံ server က ချက်ချင်း တာဝန်ယူတယ်။
ဘယ်လို အလုပ်လုပ်တာလဲ ဆိုတော့ အဆင့်သုံးဆင့် ရှိတယ် —
Heartbeat check — စောင့်ကြည့်တဲ့ စနစ် (monitor) က အဓိက server ကို စက္ကန့်အနည်းငယ်ခြားတစ်ခါ “အသက်ရှင်သေးလား?” လို့ လှမ်းမေးတယ်။ ပြန်မဖြေရင် ပျက်ပြီလို့ သတ်မှတ်တယ်
Switch over — traffic အားလုံးကို အရံ server ဆီ လွှဲချလိုက်တယ်။ DNS ဒါမှမဟုတ် load balancer က ဒီအလုပ်ကို လုပ်တယ်
Recovery — အဓိက server ပြန်ကောင်းလာရင် data တွေ sync လုပ်ပြီး မူလအတိုင်း ပြန်ထားတယ် (ဒါမှမဟုတ် အရံကိုပဲ အဓိကအဖြစ် ဆက်ထားလိုက်တယ်)
Failover အမျိုးအစား နှစ်မျိုး ရှိတယ် —
Active-Passive — အဓိက တစ်လုံးပဲ အလုပ်လုပ်တယ်၊ အရံက ထိုင်စောင့်နေတယ်။ ရိုးရှင်းတယ်၊ ဒါပေမယ့် အရံ server က အလုပ်မလုပ်ဘဲ ငွေကုန်နေတယ် (စပယ်ယာတိုင်ယာ ကားထဲမှာ အပိုသယ်ထားသလိုပေါ့)
Active-Active — နှစ်လုံးစလုံး တစ်ပြိုင်နက် အလုပ်လုပ်တယ်။ တစ်လုံး ပျက်ရင် ကျန်တစ်လုံးက ဆက်လုပ်တယ်။ ပိုမြန်တယ်၊ ဒါပေမယ့် data နှစ်ဖက် တူညီနေအောင် ထိန်းရတာ ခက်တယ်
လက်တွေ့ ဥပမာတွေ —
ဘဏ် website တွေ၊ mobile banking app တွေ — ည 2 နာရီမှာ server ပျက်လို့ “မနက်မှ ပြန်လာပါ” လို့ ပြောလို့ မရဘူး။ Failover နဲ့ 24/7 လည်ပတ်တယ်
Facebook, YouTube တို့လို ဝန်ဆောင်မှုကြီးတွေ — data center တစ်ခုလုံး မီးလောင်သွားတောင် တခြား data center က ဆက်ပေးတယ် (ဒါကို disaster recovery လို့ ခေါ်တယ်)
ကိုယ်တို့ သုံးနေတဲ့ cloud (AWS, Google Cloud) မှာ “Multi-AZ” ဆိုတာ ဒေသမတူတဲ့ server ခန်းတွေကြား failover လုပ်ထားတာပဲ
အားနည်းချက်လည်း ရှိတယ် — အဓိကက ဈေးကြီးတယ်။ Server နှစ်လုံး ဝယ်ရတယ်၊ နှစ်လုံးစာ လျှပ်စစ်မီတာခ ပေးရတယ်။ အသေးစား blog လောက်ဆို failover လုပ်ဖို့ မတန်ဘူး — server ပျက်ရင် 10 မိနစ်လောက် ပြန်တက်အောင် စောင့်လိုက်ရုံပဲ။ ဒါပေမယ့် ဘဏ်လို၊ ဆေးရုံလို၊ လေယာဉ်လက်မှတ်စနစ်လို “မပျက်ရဘူး” ဆိုတဲ့နေရာတွေမှာ failover က မရှိမဖြစ်။
ကျွန်တော် တစ်ခါ ကိုယ့် website server ပျက်သွားဖူးတယ်။ ည 11 နာရီ၊ လူတွေ အိပ်နေတဲ့အချိန် — မနက် 6 နာရီမှ သတိထားမိတယ်။ 7 နာရီကြာ website သေနေခဲ့တယ်။ အဲဒီနေ့ကစပြီး အရေးကြီးတဲ့ project တိုင်းမှာ အနည်းဆုံး database backup + standby server တစ်လုံး ထားတယ်။ “မပျက်ဘူး” လို့ အာမခံလို့ မရပေမယ့် “ပျက်ရင် ချက်ချင်း ပြန်တက်မယ်” လို့ အာမခံနိုင်တယ်။ ဒါပဲ failover ရဲ့ အဓိပ္ပာယ်ပါ။ 🙂