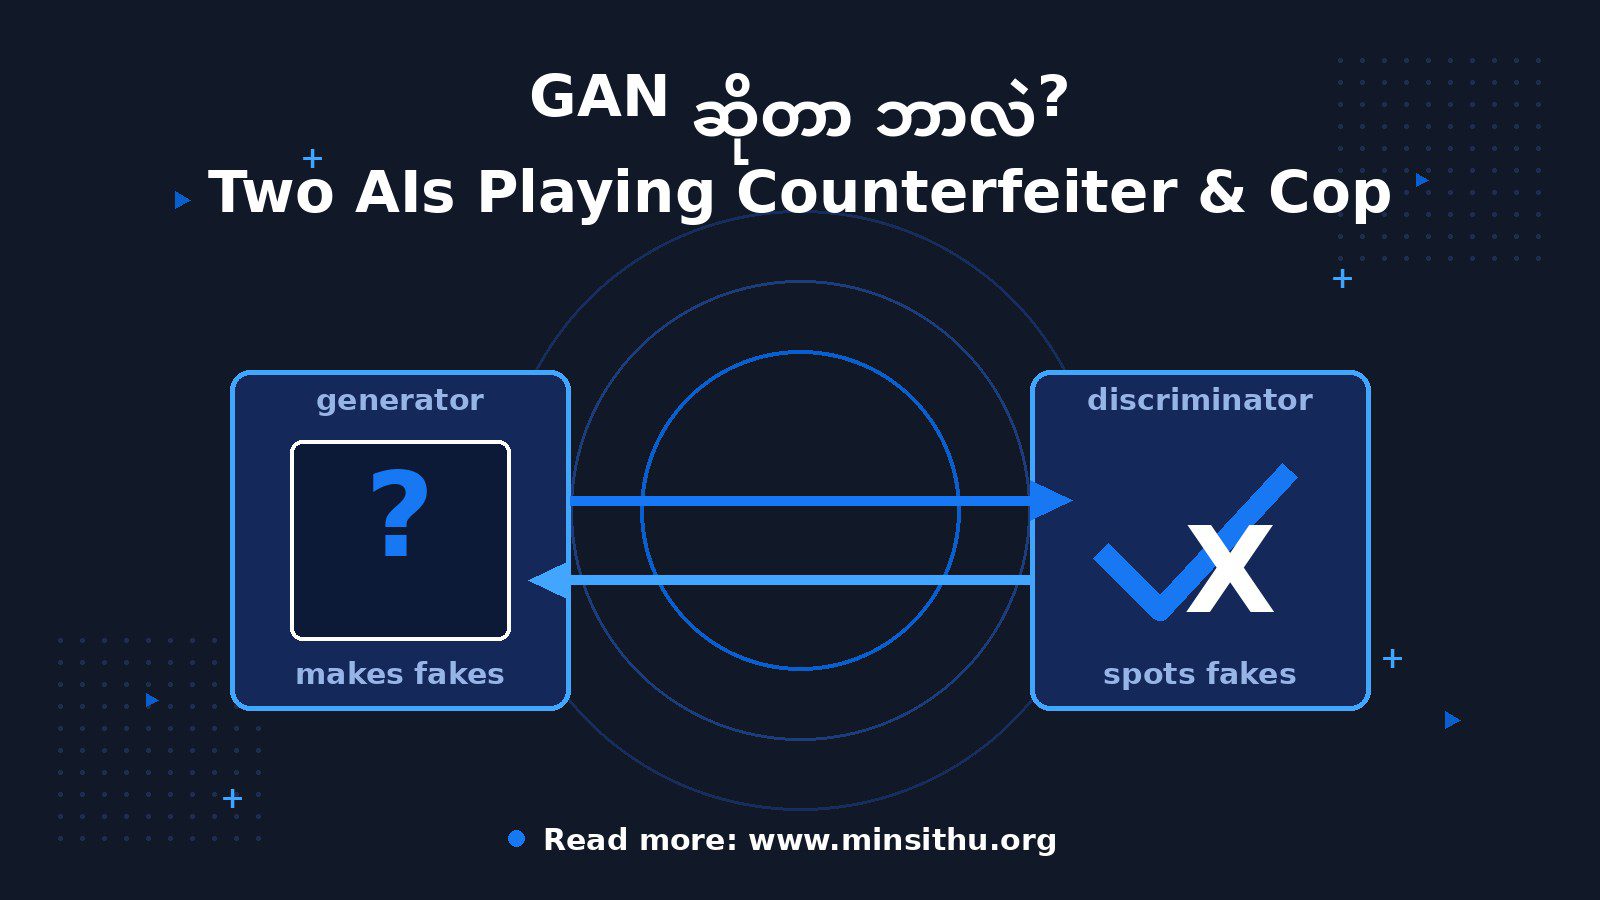
လွယ်လွယ်ပြောရရင် GAN (Generative Adversarial Network) ဆိုတာ AI နှစ်ခုကို တစ်ယောက်နဲ့တစ်ယောက် ပြိုင်ခိုင်းပြီး သင်ပေးတဲ့ နည်းလမ်း။ တစ်ယောက်က ပုံတု ထုတ်တယ်၊ နောက်တစ်ယောက်က အဲဒီပုံ အစစ်လား အတုလား ဖမ်းတယ်။ နှစ်ယောက်လုံး ပြိုင်ရင်းပြိုင်ရင်း နှစ်ယောက်လုံး တော်လာတယ်။
ဥပမာ ပြောရအောင် — ပိုက်ဆံတု ရိုက်တဲ့ သူခိုးတစ်ယောက်နဲ့ ဘဏ်ဝန်ထမ်း တစ်ယောက်ကို စဉ်းစားကြည့်ပါ။ သူခိုးက ပိုက်ဆံတု ထုတ်တယ်၊ ဝန်ထမ်းက အစစ်လား အတုလား စစ်တယ်။ ပထမဆုံး ထုတ်တဲ့ ပိုက်ဆံတုက ရုပ်ဆိုးတယ်၊ ဝန်ထမ်းက ချက်ချင်း ဖမ်းမိတယ်။ ဒါပေမယ့် သူခိုးက ဘယ်နေရာမှာ ဖမ်းခံရတယ်ဆိုတာ သိသွားပြီး နောက်တစ်ခါ ပိုကောင်းအောင် ထုတ်တယ်။ ဝန်ထမ်းကလည်း ပိုက်ဆံတု ပိုကောင်းလာတိုင်း စစ်တဲ့ နည်းလမ်း ပိုတိုးတက်လာတယ်။ ဒီလိုနဲ့ နှစ်ယောက်လုံး ရက်တွေကြာလာတော့ အရမ်းတော်လာကြတယ်။ GAN က အတိအကျ ဒီပုံစံပဲ။
နည်းပညာအရ ဒီ AI နှစ်ခုရဲ့ နာမည်က Generator နဲ့ Discriminator။ Generator က “ဖန်တီးသူ” — စစချင်း random noise (အသံဆူညံမှုလို အမှုန့်တွေ) ကနေ ပုံတစ်ပုံ ထုတ်တယ်။ ပထမဆုံး ထုတ်တဲ့ ပုံတွေက မှုန်ဝါးပြီး ဘာမှန်းမသိဘူး။ Discriminator က “စစ်ဆေးသူ” — ဒီပုံအစစ်လား Generator ထုတ်တဲ့ ပုံတုလား ခွဲရတယ်။ Generator ထုတ်တဲ့ ပုံတုကို Discriminator က “အတု” လို့ ဖမ်းမိလိုက်တိုင်း Generator က “အိုး ဒီလိုထုတ်ရင် ဖမ်းခံရတယ်” လို့ သင်ယူပြီး နောက်တစ်ခါ ပိုလိမ်လို့ရအောင် ထုတ်တယ်။ Discriminator ကလည်း ဖမ်းမမိလိုက်တိုင်း “ဒီလိုပုံကျတော့ အတုဖြစ်နိုင်တယ်” လို့ မှတ်သားထားတယ်။ ဒီလို တစ်သိန်းခေါက်လောက် ပြိုင်ပြီးသွားတဲ့အခါ Generator ထုတ်တဲ့ ပုံတွေက အစစ်နဲ့ ခွဲမရလောက်အောင် ကောင်းလာတယ်။
GAN နဲ့ တကယ်လုပ်ထားတဲ့ အရာတွေ ကြည့်ရအောင်။ StyleGAN ဆိုတဲ့ model က လူမျက်နှာ ပုံတုတွေ ထုတ်တယ် — thispersondoesnotexist.com မှာ တွေ့ရတဲ့ “ဒီလူ တကယ်မရှိဘူး” ဆိုတဲ့ မျက်နှာတွေက StyleGAN ထုတ်ထားတာပဲ။ နောက်တစ်ခု နာမည်ကြီးတာက deepfake video တွေ — လူတစ်ယောက်ရဲ့ မျက်နှာကို တခြားသူ့ခန္ဓာကိုယ်ပေါ် တင်တဲ့ နည်းပညာနောက်ကွယ်မှာလည်း GAN ပါတယ်။ ကောင်းတဲ့ ဘက်ကပြောရရင် game တွေမှာ texture ဖန်တီးတာ၊ ဆေးပညာမှာ MRI ပုံတုထုတ်ပြီး AI သင်ပေးတာ၊ ဓာတ်ပုံ အရည်အသွေးမြှင့်တဲ့ (super-resolution) tool တွေမှာလည်း GAN သုံးတယ်။
ဒါပေမယ့် GAN ရဲ့ အားနည်းချက်တစ်ခုရှိတယ် — training လုပ်ရတာ တော်တော်ခက်တယ်။ သူခိုးနဲ့ ဝန်ထမ်း ပြိုင်တဲ့ ဥပမာမှာ တစ်ယောက်က အရမ်းတော်ပြီး နောက်တစ်ယောက်က အရမ်းညံ့နေရင် ပြိုင်ပွဲက ပျက်သွားတယ်။ Discriminator က အရမ်းတော်နေရင် Generator က ဘာထုတ်ထုတ် ချက်ချင်းဖမ်းခံရပြီး ဘာမှ မသင်ရဘူး။ ဒီပြဿနာကို “mode collapse” လို့ခေါ်တယ် — Generator က ပုံတစ်မျိုးတည်းပဲ ထုတ်တတ်သွားတာ။ ဥပမာ မျက်နှာပုံထုတ်တဲ့ GAN က မျက်နှာတစ်မျိုးတည်းပဲ ထပ်ခါထပ်ခါ ထုတ်နေတာမျိုး။ ဒါကြောင့် GAN train လုပ်ရတာ အနုပညာတစ်မျိုးလို ဖြစ်နေတာ။
ဒီနေ့ခေတ် ပုံထုတ် AI တွေမှာ (Midjourney, DALL-E, Stable Diffusion) GAN အစား Diffusion model တွေ သုံးလာကြတယ် — ဘာလို့လဲဆိုတော့ diffusion က train ရတာ ပိုတည်ငြိမ်ပြီး ပုံအရည်အသွေး ပိုကောင်းလို့ပဲ။ ဒါပေမယ့် GAN က အခုထိ video နဲ့ real-time application တွေမှာ မြန်လို့ သုံးနေကြတုန်းပဲ။ NVIDIA ရဲ့ DLSS လို game graphics မြှင့်တဲ့ နည်းပညာနောက်ကွယ်မှာလည်း GAN စိတ်ကူးပါတယ်။
စိတ်ဝင်စားစရာကောင်းတာက GAN ရဲ့ အတွေးအခေါ်ပဲ။ AI ကို သင်ပေးတဲ့ နည်းလမ်းအများစုက “အဖြေမှန်ပြပြီး သင်တာ”။ GAN ကတော့ “ပြိုင်ဘက်ထားပြီး သင်တာ”။ လူတွေလည်း ဒီလိုပဲ မဟုတ်လား — စာမေးပွဲမှာ အမှတ်ကောင်းချင်ရင် ကိုယ့်ထက် တော်တဲ့ သူငယ်ချင်းနဲ့ ပြိုင်ဖြေရင် ပိုတိုးတက်သလိုမျိုး။ AI လောကမှာ ဒီအတွေးက အခုထိ အသစ်အဆန်း နည်းလမ်းတွေ မွေးထုတ်နေတုန်းပဲ။
ကျွန်တော် GAN ကို စလေ့လာတုန်းက အံ့ဩသွားတာ တစ်ခုရှိတယ် — Generator က ဘယ်တုန်းကမှ “အစစ်အမှန်” ပုံကို မမြင်ဖူးဘူး။ သူ မြင်ဖူးတာက Discriminator ရဲ့ “အတု” ဆိုတဲ့ ဆုံးဖြတ်ချက်ပဲ။ ဒါပေမယ့် အဲဒီ feedback တစ်ခုတည်းနဲ့ အစစ်နီးပါး ပုံတွေ ထုတ်တတ်သွားတယ်။ ဝေဖန်မှုကနေ သင်ယူတာဟာ ဘယ်လောက်ထိ အစွမ်းထက်လဲဆိုတာ ပြတဲ့ သင်ခန်းစာကောင်းတစ်ခုပဲ မဟုတ်လား။ 🙂
===