လွယ်လွယ်ပြောရရင် diffusion model ဆိုတာ စာတစ်ကြောင်းရေးပေးလိုက်ရင် ပုံတစ်ပုံထုတ်ပေးတဲ့ AI ပါ။ Midjourney, DALL-E, Stable Diffusion — ဒီနာမည်တွေ ကြားဖူးရင် အဲဒါတွေရဲ့ နောက်ကွယ်မှာ diffusion model ရှိနေတာပါ။
မှန်မှုန်ကို တွေးကြည့်ပါ။
ရေချိုးခန်းထဲက မှန်ကို စဉ်းစားကြည့် — ရေငွေ့တွေကြောင့် မှုန်နေတယ်၊ မျက်နှာကို မမြင်ရဘူး။ လက်နဲ့ တစ်ဖြည်းဖြည်း သုတ်လိုက်ရင် အမှုန်တွေ ပျောက်သွားပြီး မျက်နှာ ပေါ်လာတယ်။
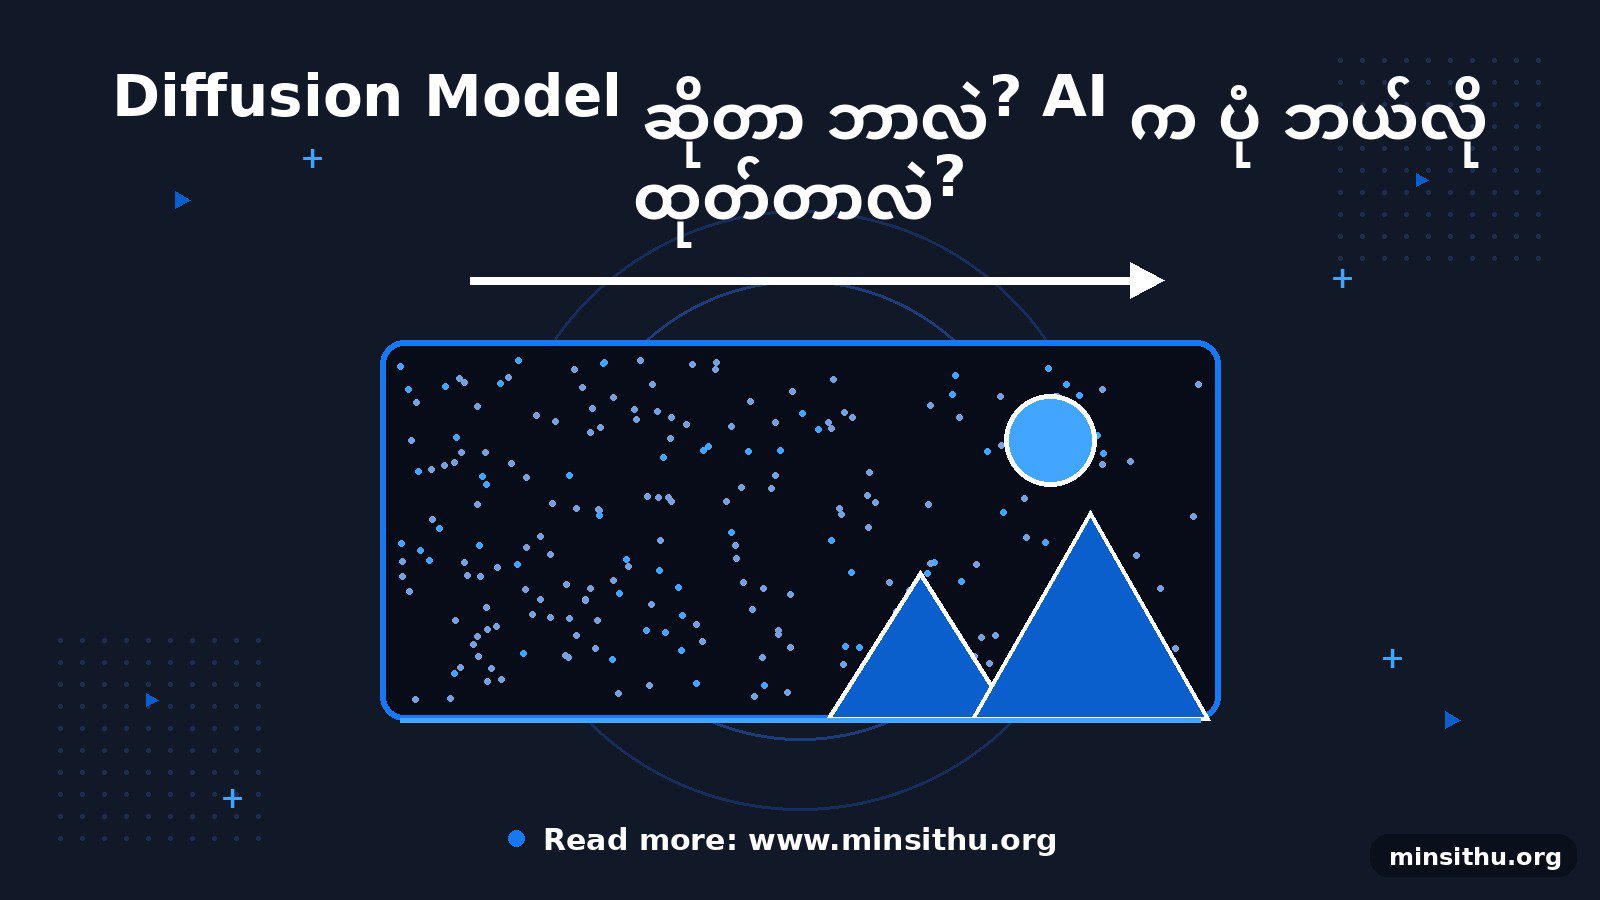
Diffusion model က ဒီအတိုင်းပဲ အလုပ်လုပ်တယ်။ အစက TV အသံမထွက်ဘဲ ဖွင့်ထားသလို အမှုန်အမွှား (noise) တွေပဲ ရှိတယ်။ ပြီးရင် အဲဒီအမှုန်တွေကို တစ်ထစ်ချင်း ဖယ်ရှားသွားတယ် — ဖယ်ရှားလေ ပုံပေါ်လာလေ။ အဆုံးမှာ ကိုယ်ရေးပေးလိုက်တဲ့ စာနဲ့ ကိုက်ညီတဲ့ ပုံတစ်ပုံ ထွက်လာတယ်။ “a cat sitting on a motorcycle at sunset” လို့ ရေးပေးရင် ကြောင်တစ်ကောင် ဆိုင်ကယ်ပေါ်ထိုင်နေတဲ့ နေဝင်ချိန်ပုံ ထွက်လာတယ်။
သင်ပေးတဲ့နည်း (Training)
AI ကို ဘယ်လို သင်ပေးလဲဆိုတော့ နည်းက ရယ်စရာကောင်းတယ် — ပုံကို အရင် ဖျက်ပစ်တာ။
ပုံအစစ်သန်းပေါင်းများစွာကို ယူတယ် (internet ပေါ်က ပုံတွေ)
ပုံတစ်ပုံချင်းစီမှာ noise ကို တစ်ဖြည်းဖြည်း ထည့်သွားတယ် — ပုံကြည်ကနေ အမှုန်ပုံအထိ
ပြီးရင် AI ကို “ဒီအမှုန်ပုံကနေ မူလပုံကို ပြန်ထုတ်စမ်း” လို့ ခိုင်းတယ်
မှားရင် ပြင်တယ်၊ မှန်ရင် မှတ်တယ် — သန်းပေါင်းများစွာ ထပ်လုပ်တယ်
နောက်ဆုံးမှာ AI က “အမှုန်တွေထဲကနေ ပုံကို ပြန်ဖော်ထုတ်တဲ့” ပညာကို တတ်သွားတယ်။
သုံးတဲ့အခါ (ပုံထုတ်တဲ့အခါ)
ကိုယ် prompt ရိုက်ထည့်လိုက်တဲ့အခါ AI က လုပ်တာက —
အမှုန်သက်သက် ပုံအလွတ်တစ်ပုံနဲ့ စတယ်
prompt ထဲက စာလုံးတွေကို ဖတ်ပြီး “ဒီပုံမှာ ဘာပါရမယ်” ဆိုတာ နားလည်တယ် (ဒီနေရာမှာ transformer နည်းပညာလည်း ပါဝင်တယ် — အရင်က ရေးဖူးတယ်)
အမှုန်တွေကို အဆင့် ၂၀-၅၀ လောက် တစ်ဆင့်ချင်း ဖယ်ရှားသွားတယ်
ဖယ်ရှားလိုက်တိုင်း ပုံက ပိုပိုပြီး ကြည်လင်လာတယ်
ဒါကြောင့် Midjourney မှာ ပုံထုတ်ရင် အမှုန်ပုံကနေ တစ်ဖြည်းဖြည်း ကြည်လာတာ မြင်ရတာ — အဲဒါ diffusion ရဲ့ အဆင့်တွေကို live ကြည့်နေရတာပဲ။
ကိုယ်တိုင် စမ်းကြည့်လို့ရတယ်
အခမဲ့ စမ်းလို့ရတဲ့ နေရာတွေ အများကြီးရှိတယ် —
Bing Image Creator (Microsoft) — အကောင့်ဖွင့်ရုံနဲ့ အခမဲ့သုံးလို့ရတယ်
Stable Diffusion — ကိုယ့်ကွန်ပျူတာမှာ ကိုယ်တိုင် run လို့ရတယ် (GPU ကောင်းရင်)
Leonardo.ai, Playground — browser ထဲကနေ သုံးလို့ရတယ်
Prompt ရေးတဲ့အခါ တိတိကျကျရေးလေ ပုံကောင်းလေပဲ။ “cat” ထက် “a fluffy orange cat sitting on a wooden table, warm sunlight, photorealistic” ဆိုတာ ပိုကောင်းတယ်။
သတိထားစရာ တစ်ခုတော့ ရှိတယ် — ဒီပုံတွေက “အစစ်” မဟုတ်ဘူး။ AI က ဖန်တီးထားတာ။ သတင်းပုံအဖြစ် သုံးတာ၊ လူတစ်ယောက်ရဲ့ မျက်နှာကို အတုလုပ်တာမျိုးတော့ မလုပ်သင့်ဘူး။
ဒါပေမဲ့ ကိုယ့် blog အတွက် cover ပုံ၊ presentation အတွက် illustration၊ စိတ်ကူးကို အမြန်ပုံဖော်ကြည့်တာ — ဒါတွေအတွက်တော့ diffusion model က အရမ်းအသုံးဝင်တဲ့ ကိရိယာပဲ။ မှန်မှုန်ကို သုတ်လိုက်သလို စိတ်ကူးကို ပုံအဖြစ် ပေါ်လာအောင် လုပ်ပေးနိုင်တယ်။ နောက်တစ်ခါ AI ပုံလှလှလေး တွေ့ရင် “အော်၊ ဒါ diffusion နဲ့ ထုတ်ထားတာပဲ” လို့ သိလိုက်တော့။ 😉