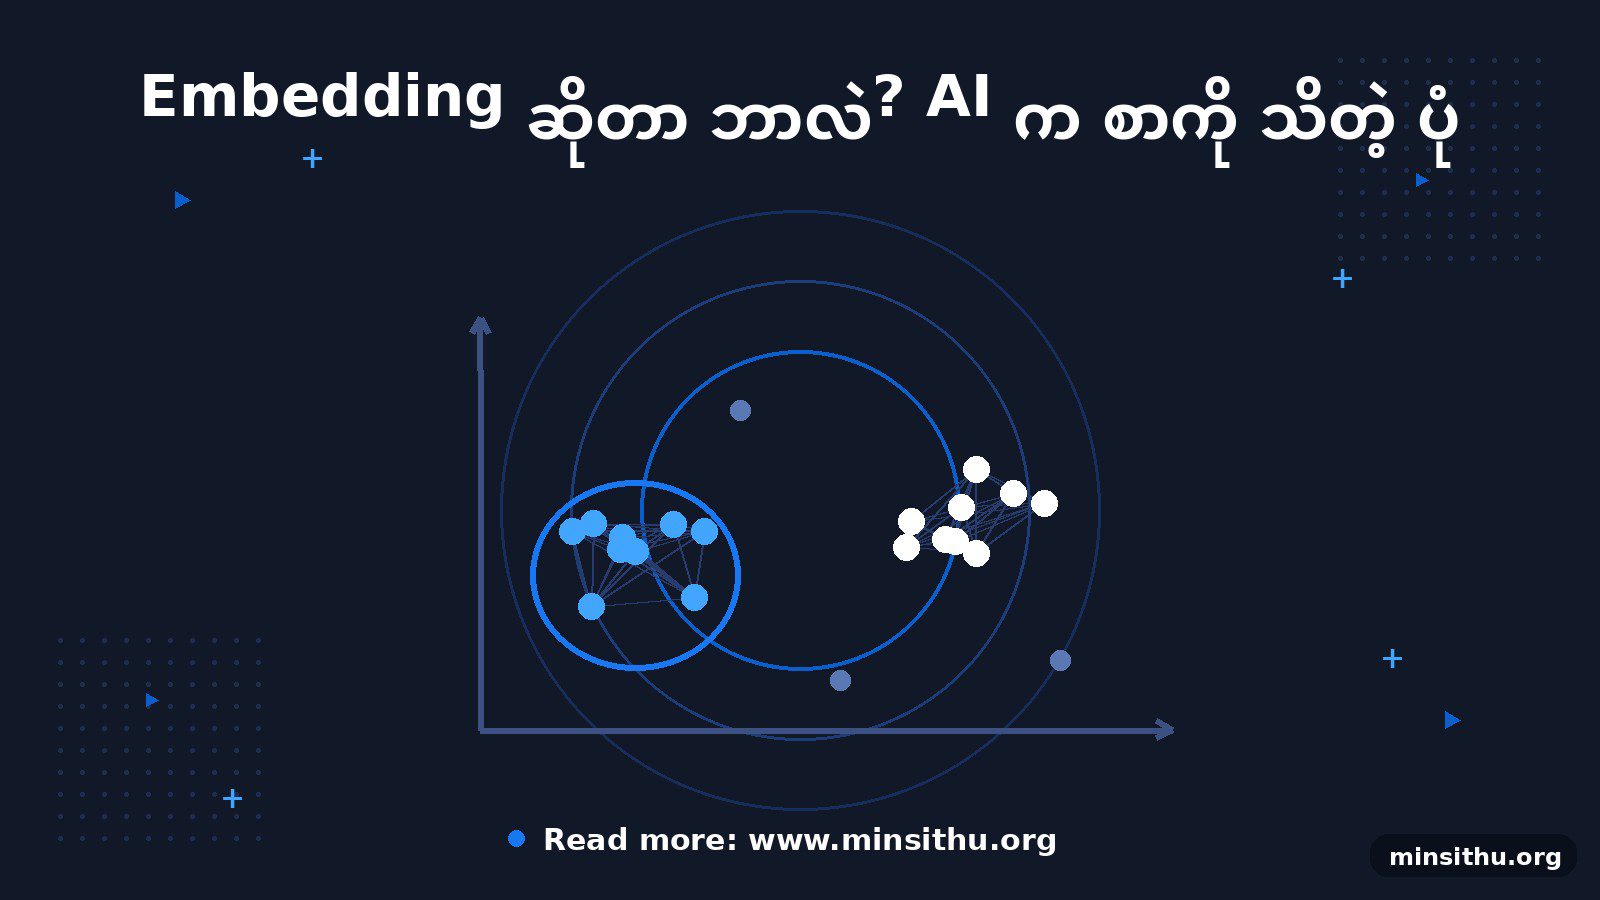
လွယ်လွယ်ပြောရရင် embedding ဆိုတာ စာသား (စာလုံး တစ်လုံး၊ စာကြောင်း တစ်ကြောင်း) ကို ကိန်းဂဏန်း အတွဲလိုက် (ဥပမာ [0.21, -0.87, 0.55, …] လို ဂဏန်း ရာချီပါတဲ့ စာရင်း) အဖြစ် ပြောင်းထားတာပါ။ AI က စာကို ကိုယ်တို့လို “ဖတ်ပြီး နားလည်” တာမဟုတ်ဘူး — စာရဲ့ အဓိပ္ပာယ်ကို ကိန်းဂဏန်းပုံစံနဲ့ မှတ်ထားတာ။
ဒါကို နားလည်ဖို့ အလွယ်ဆုံး ဥပမာက မြေပုံပါ။
မြေပုံပေါ်မှာ ရန်ကုန်နဲ့ မန္တလေးက တစ်နေရာတည်း မဟုတ်ပေမဲ့ တစ်နိုင်ငံတည်းမို့လို့ နီးနီးလေးပဲ။ ရန်ကုန်နဲ့ တိုကျိုကျတော့ ဝေးတယ်။ “နီးတယ် / ဝေးတယ်” ဆိုတာ အကွာအဝေးကို ပြောတာပါ။
Embedding လည်း ဒီအတိုင်းပါပဲ — စာလုံးတွေကို “အဓိပ္ပာယ် မြေပုံ” ပေါ်မှာ နေရာချထားတာ။
“ကြောင်” နဲ့ “ခွေး” — နှစ်လုံးစလုံး အိမ်မွေးတိရစ္ဆာန်မို့လို့ မြေပုံပေါ်မှာ နီးနီးလေး ရှိနေမယ်
“ကြောင်” နဲ့ “စက်ဘီး” — ဘာမှ မဆိုင်လို့ ဝေးဝေးမှာ ရှိနေမယ်
“ပျော်” နဲ့ “ဝမ်း” — ခံစားချက်ချင်း တူလို့ နီးနေမယ်
AI က စာလုံးတစ်လုံးကို ကိန်းဂဏန်း အတွဲလိုက် ပြောင်းလိုက်တဲ့အခါ အဲဒီဂဏန်းတွေက မြေပုံပေါ်က “လိပ်စာ” (coordinate) ဖြစ်သွားတယ်။ လိပ်စာချင်း နီးရင် အဓိပ္ပာယ်ချင်း ဆင်တယ် — ဒါကို AI က တွက်ချက်လို့ရတယ်။
ဘာလို့ ကိန်းဂဏန်းနဲ့ ပြောင်းရတာလဲ?
Computer က စာကို တိုက်ရိုက် “နားမလည်” ဘူး။ Computer နားလည်တာ ဂဏန်းပဲ။ ဒါကြောင့် AI model တွေက စာသားတိုင်းကို အရင်ဆုံး embedding အဖြစ် ပြောင်းတယ် — ပြီးမှ အဲဒီ ဂဏန်းတွေနဲ့ တွက်ချက်တာ။ ChatGPT ကို စာရိုက်ထည့်လိုက်တာနဲ့ ပထမဆုံး လုပ်တာ ဒါပဲ — စာကို embedding ပြောင်းတာ။ Token အကြောင်း အရင်က ရေးဖူးတယ် — token က စာကို အပိုင်းပိုင်းခွဲတာ၊ embedding က အဲဒီအပိုင်းတစ်ခုချင်းစီကို ဂဏန်းအဖြစ် ပြောင်းတာ။ နှစ်ခု တွဲပြီး အလုပ်လုပ်တယ်။
နေ့တိုင်း သုံးနေတဲ့ နေရာတွေ
Embedding ကို ကိုယ် မသိဘဲ နေ့တိုင်း သုံးနေတယ် —
Search — Google မှာ “ဈေးအသက်သာဆုံး ဖုန်း” လို့ ရိုက်ရှာရင် “ဈေးနှုန်းချိုသာသော smartphone” လို့ ရေးထားတဲ့ page တွေလည်း ရလဒ်ထဲ ပါလာတယ်။ စာလုံး မတူပေမဲ့ အဓိပ္ပာယ် တူတာကို embedding က သိလို့။
Recommendation — YouTube က “ဒါကြည့်ပြီးရင် ဒါဆက်ကြည့်ပါ” လို့ ညွှန်းတာ။ Video တွေရဲ့ အကြောင်းအရာကို embedding နဲ့ တိုင်းပြီး ဆင်တာတွေ ညွှန်းတာ။
RAG — အရင်က ရေးဖူးတဲ့ RAG (AI ကို စာကြည့်တိုက်မှူးခန့်သလို လုပ်တာ) ရဲ့ အခြေခံက embedding ပဲ။ စာရွက်စာတမ်း ထောင်ချီကို embedding လုပ်ပြီး သိမ်းထား၊ မေးခွန်းလာမှ အဓိပ္ပာယ်အနီးဆုံး စာရွက်ကို ဆွဲထုတ်တာ။
Spam filter — “အခမဲ့ ငွေရမယ်!!!” ဆိုတဲ့ mail တွေကို အလိုလို spam ထဲ ပို့တာ။ Spam စာတွေရဲ့ embedding ပုံစံကို မှတ်ထားလို့။
ကိုယ်တိုင် စမ်းကြည့်လို့ရလား?
ရတယ်။ Python မှာ sentence-transformers ဆိုတဲ့ library ရှိတယ်။
from sentence_transformers import SentenceTransformer

model = SentenceTransformer('all-MiniLM-L6-v2')
v1 = model.encode("ကြောင်")
v2 = model.encode("ခွေး")
v3 = model.encode("စက်ဘီး")
v1, v2, v3 တစ်ခုချင်းစီက ဂဏန်း ၃၈၄ လုံး ပါတဲ့ စာရင်း (vector) ဖြစ်မယ်။ ပြီးရင် v1 နဲ့ v2 ကြားက အကွာအဝေး၊ v1 နဲ့ v3 ကြားက အကွာအဝေး တွက်ကြည့်လိုက် — ကြောင်-ခွေး က ပိုနီးနေတာ တွေ့ရမယ်။ ဒါပဲ — အဓိပ္ပာယ်ကို ဂဏန်းနဲ့ တိုင်းတာ။
မှတ်ထားစရာ တစ်ခုက embedding က ဘာသာစကားနဲ့ မဆိုင်ဘူး — အဓိပ္ပာယ်နဲ့ပဲ ဆိုင်တယ်။ “cat” နဲ့ “ကြောင်” ရဲ့ embedding က နီးနီးလေး ဖြစ်နေတတ်တယ်။ ဘာသာစကား မတူပေမဲ့ အဓိပ္ပာယ် တူလို့။
Embedding ဆိုတာ AI ရဲ့ “အဓိပ္ပာယ် မြေပုံ” ပဲ။ စာလုံးတိုင်းမှာ လိပ်စာရှိတယ်၊ လိပ်စာချင်း နီးရင် အဓိပ္ပာယ်ချင်း ဆင်တယ်။ နောက်တစ်ခါ Google search က ကိုယ် ရိုက်တာနဲ့ မတူတဲ့ စာလုံးတွေနဲ့ မှန်တဲ့ အဖြေပေးလာရင် တွေးကြည့်လိုက် — “အော်၊ embedding က အဓိပ္ပာယ် တိုင်းပေးလိုက်တာပဲ” လို့။ 🙂